Bán chạy nhất
Bán chạy nhất
Bán chạy nhất
Bán chạy nhất
Bán chạy nhất
TPU (Tensor Processing Unit) là con chip ASIC do Google tự phát triển, chuyên để tăng tốc các phép tính ma trận trong học máy. Khác với CPU làm được nhiều việc hoặc GPU làm tốt việc song song nói chung, TPU được thiết kế riêng cho tính toán mạng nơ-ron. Bài này giải thích TPU hoạt động ra sao, khác CPU và GPU ở đâu, khi nào hợp dùng và nếu tự dựng máy để học AI tại nhà thì nên chọn gì.

Theo Google Cloud, TPU là vi mạch tích hợp chuyên dụng (ASIC) do Google phát triển để tăng tốc các tác vụ học máy. Chip được thiết kế cho các phép toán ma trận lớn thường gặp trong thuật toán học máy và có bộ nhớ băng thông cao (HBM) ngay trên chip, giúp chạy mô hình và kích thước batch lớn hơn. Nhiều TPU có thể nối thành nhóm gọi là slice để mở rộng tải. Nếu bạn chưa quen khái niệm học máy, bài Machine Learning là gì giải thích phần nền tảng trước.
Mạng nơ-ron cần cực nhiều phép nhân và cộng giữa dữ liệu đầu vào và tham số, được tổ chức thành phép nhân ma trận. Google Cloud giải thích CPU là bộ xử lý đa dụng theo kiến trúc von Neumann: mỗi phép tính phải đọc ghi kết quả qua bộ nhớ nên bị thắt cổ chai. GPU dùng nhiều đơn vị ALU chạy song song (Google nêu khoảng 2.500 đến 5.000 ALU mỗi bộ xử lý) nên thông lượng cao hơn CPU nhiều, nhưng vẫn là bộ xử lý đa dụng nên còn truy cập thanh ghi hoặc bộ nhớ chia sẻ cho mỗi phép tính.
TPU đi theo hướng khác: vì biết trước các bước xử lý ma trận, Google nối hàng nghìn bộ nhân và cộng trực tiếp với nhau thành một ma trận vật lý gọi là systolic array. Ở Cloud TPU v2, mỗi bộ xử lý có hai systolic array 128 x 128, tổng 32.768 ALU cho số thực 16 bit. Kết quả nhân được chuyển thẳng sang bộ nhân kế tiếp để cộng dồn, nên trong quá trình này không cần truy cập bộ nhớ. Đổi lại, TPU không chạy được các việc đa dụng như CPU.
| Bộ xử lý | Thiết kế | Điểm mạnh | Hạn chế |
|---|---|---|---|
| CPU | Đa dụng, kiến trúc von Neumann | Linh hoạt, chạy được mọi loại chương trình | Mỗi phép tính phải qua bộ nhớ, thông lượng thấp hơn với ma trận lớn |
| GPU | Nhiều ALU chạy song song | Thông lượng cao với phép nhân ma trận, dùng được cho đồ họa lẫn AI | Vẫn là bộ xử lý đa dụng, còn tốn năng lượng cho truy cập thanh ghi |
| TPU | ASIC chuyên cho mạng nơ-ron, có systolic array | Xử lý ma trận nhanh, tiết kiệm điện theo mô tả của Google | Không chạy được tác vụ đa dụng, không phải thiết bị để bạn tự lắp vào PC |

Trang tài liệu của Google Cloud nêu rõ các trường hợp TPU hợp với những mô hình có phép tính ma trận chiếm chủ đạo, vòng huấn luyện chính không có phép toán PyTorch hoặc JAX tùy biến, huấn luyện kéo dài nhiều tuần đến nhiều tháng, mô hình lớn có batch hiệu dụng lớn, hoặc mô hình có embedding cực lớn như xếp hạng và gợi ý. Ngược lại, TPU không phù hợp với chương trình đại số tuyến tính có nhiều rẽ nhánh hoặc phép tính theo từng phần tử, tác vụ cần số học độ chính xác cao, mạng có phép toán tùy biến trong vòng huấn luyện chính, hay mô hình có hình dạng tensor thay đổi vì đồ thị được biên dịch theo batch đầu tiên.
| Tình huống | Hướng phù hợp |
|---|---|
| Huấn luyện mô hình lớn, chạy nhiều tuần, dùng dịch vụ đám mây | Có thể xem xét TPU trên Google Cloud |
| Học AI, thử nghiệm mô hình, làm đồ án trên máy cá nhân | GPU NVIDIA trên PC hoặc laptop |
| Cần chạy nhiều loại tác vụ khác nhau, kể cả đồ họa và game | GPU, vì TPU không dành cho việc đa dụng |
| Mô hình có phép toán tùy biến hoặc hình dạng dữ liệu thay đổi | GPU linh hoạt hơn theo mô tả của Google |
Điểm cần nhớ là TPU là dịch vụ bạn thuê qua đám mây (Google nêu các đường truy cập qua Compute Engine, Google Kubernetes Engine), không phải linh kiện bán lẻ để lắp vào máy. Vì thế người học AI tại nhà gần như chỉ có đường chọn GPU.
![]() | ![]() | ![]() |
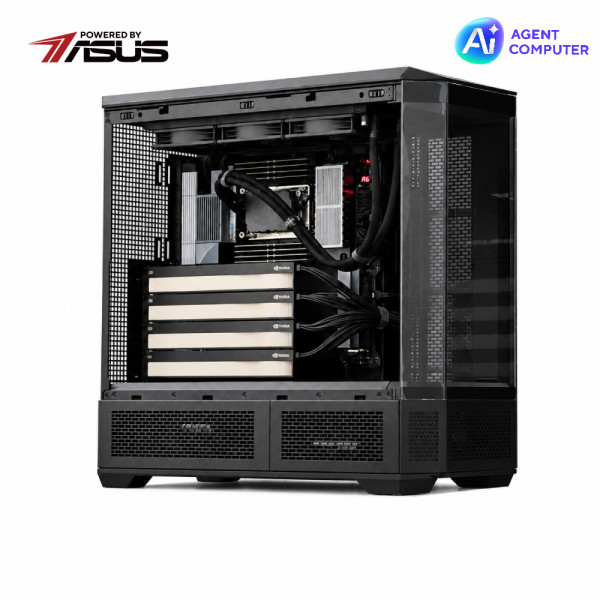
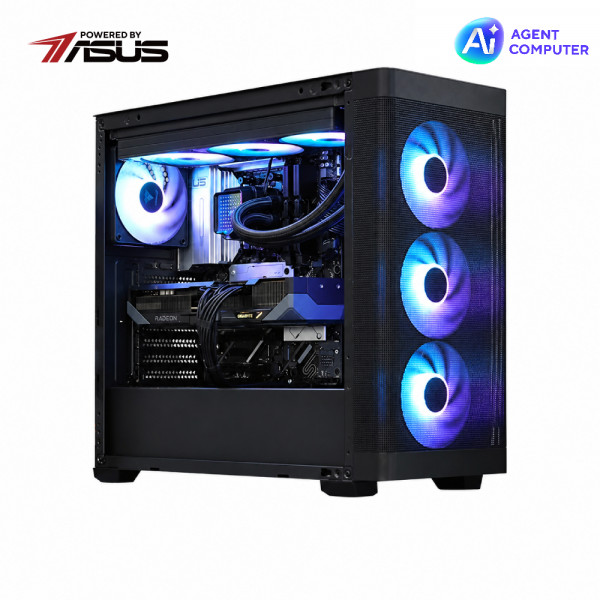
Từ trái sang: PC AI Ryzen 9 9950X với RTX PRO 5000 Blackwell 48GB, Agent Computer 9950X3D với RTX 5080, Agent Computer 9900X3D với RTX 5080
Nếu bạn muốn một máy chạy được mô hình mà không phải thuê đám mây, nhóm bộ PC chạy AI của Nguyễn Công đã cân đối sẵn CPU, RAM và card. Nhu cầu chạy tác tử AI có thể xem Agent Computer, còn người học di động có laptop AI. Tự ghép máy thì bắt đầu từ card NVIDIA RTX 5000 Series, và khi cần nhiều VRAM hơn cho mô hình lớn thì xem RTX PRO 6000 Blackwell. Đừng quên RAM DDR5 và ổ SSD đủ dung lượng, vì bộ dữ liệu lớn sẽ chiếm bộ nhớ trước khi đến GPU. Thông số từng sản phẩm bạn nên đối chiếu trên trang bán và trang của hãng.
![]() | ![]() | ![]() |
Từ trái sang: NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, Gigabyte GeForce RTX 5060 Windforce Max OC 8G, Asus Dual GeForce RTX 5060 Ti 16GB GDDR7 OC Edition
TPU (Tensor Processing Unit) là vi mạch ASIC do Google phát triển để tăng tốc các phép tính ma trận trong học máy.
Tensor Processing Unit, nghĩa là đơn vị xử lý tensor.
GPU là bộ xử lý đa dụng chạy song song nhiều ALU, dùng được cho đồ họa lẫn AI. TPU là chip chuyên cho mạng nơ-ron, có systolic array nối trực tiếp bộ nhân và cộng, nhưng không chạy được tác vụ đa dụng.
CPU đa dụng và linh hoạt nhưng mỗi phép tính phải qua bộ nhớ. TPU đặc thù cho ma trận nên bỏ được bước truy cập bộ nhớ trong lúc nhân ma trận.
Là ma trận vật lý gồm hàng nghìn bộ nhân và cộng nối trực tiếp với nhau, kết quả chuyển thẳng sang bộ kế tiếp mà không cần truy cập bộ nhớ.
Theo mô tả của Google, TPU được cung cấp dưới dạng dịch vụ đám mây qua Compute Engine, Google Kubernetes Engine. Bạn không lắp TPU của Google vào PC như một card đồ họa.
Với máy cá nhân, GPU NVIDIA là lựa chọn thực tế vì bạn mua được, lắp được và có nhiều tài liệu hướng dẫn.
Mô hình có phép tính ma trận chiếm chủ đạo, huấn luyện dài ngày, batch lớn, hoặc có embedding rất lớn như xếp hạng và gợi ý.
Chương trình nhiều rẽ nhánh hoặc phép tính từng phần tử, cần độ chính xác số học cao, có phép toán tùy biến trong vòng huấn luyện, hoặc có hình dạng tensor thay đổi.
Google mô tả TPU xử lý phép nhân ma trận mạng nơ-ron nhanh hơn trong khi tốn ít điện và chiếm ít diện tích hơn, đây là mô tả của chính Google, không phải kết quả bạn tự đo.
Một card NVIDIA đủ VRAM, CPU đủ lõi, RAM và SSD đủ dung lượng cho bộ dữ liệu. Bạn có thể xem các bộ PC chạy AI hoặc card RTX 5000 Series để chọn.
Lắp sẵn tiết kiệm thời gian cân đối CPU, RAM, card. Tự ghép linh hoạt hơn nếu bạn đã rõ mô hình và dung lượng VRAM cần dùng.
Bài viết liên quan
08-11-2026, 3:03 pm
MIL-STD-810H là bộ phương pháp thử nghiệm môi trường, không phải chứng nhận của quân đội. Bài viết giải thích các hạng mục thử trên laptop, hiểu lầm thường gặp và cách đọc thông số khi chọn mua.
07-11-2026, 2:54 pm
Card đồ họa chạy DeepSeek cần bao nhiêu VRAM? Dung lượng từng bản DeepSeek-R1, card RTX 5060 đến RTX 5090 phù hợp bản nào, DeepSeek V4 có chạy được không và gợi ý bộ PC.
07-11-2026, 2:22 pm
Đánh giá Acer Nitro ProPanel ANV16-I12-53VH (Nitro V 16): Core 5 205H, RTX 3050 4GB, màn 16 inch 16:10 165Hz, điểm benchmark, so sánh với ANV15-52-50VA và ai nên chọn.
07-11-2026, 10:57 am
So sánh Core Ultra 7 265K, 265KF, 270K Plus và Core Ultra 9 285K theo thông số Intel, cách ghép card đồ họa, RAM và 8 bộ PC gaming Core Ultra có cấu hình chi tiết.
07-11-2026, 9:07 am
So sánh Core i7-14700F với Core i5 theo thông số Intel, gợi ý khi nào đáng chọn Core i7 và điểm qua 5 bộ Core i7 có ảnh chụp thật.
06-11-2026, 4:39 pm
So sánh ba mã Core i5 trong PC gaming theo thông số Intel, gợi ý khi nào chọn mã nào và điểm qua 8 bộ Core i5 có ảnh chụp thật.
09-08-2022, 5:31 pm
Chúng ta đã có được những thông tin rằng có vẻ như CPU Ryzen 7000 Zen 4 của AMD chắc chắn sẽ có DDR5-6000, cho phép tỷ lệ IFC 1: 1.
09-08-2022, 3:20 pm
Intel đã công bố ra mắt dòng sản phẩm đồ họa Arc Pro hoàn toàn mới của mình, bao gồm Arc Pro A50, A40 & A30M dành cho desktop and mobile PCs.
09-08-2022, 10:12 am
Và khi đem những điểm số hiệu năng của 5975WX so sánh với Threadripper 3990X 64 lõi, chip Zen 3 (5975WX) 32 lõi nhanh hơn 10%, đây thật sự là một sự nâng cấp về mặt hiệu năng rất ấn tượng khi mà 3990X có gấp đôi số lõi và số luồng so với 5975WX.
08-08-2022, 6:17 pm
Dường như Intel đang đặt dấu chấm hết cho mảng kinh doanh bộ nhớ Optane của mình. Trong bản công bố tài chính quý 2 năm 2022
08-08-2022, 5:54 pm
Hạ tiến trình xuống thì kích thước bóng bán dẫn bé hơn và từ đó thì nhồi được thêm nhiều bóng bán dẫn hơn và hiệu năng cao hơn, hạ tiến trình xuống thì đồng nghĩa với việc sẽ ít tỏa nhiệt hơn tuy nhiên việc nhồi nhiều bóng bán dẫn hơn khiến CPU GPU nóng hơn đổi lại có được hiệu năng cao hơn.
08-08-2022, 9:39 am
So với AMD Ryzen 9 5950X, Intel Core i9-13900K có mức tăng hiệu suất đáng kể lên đến 67% (với Unlimited Power) và ngay cả với Limited Power, chip Raptor Lake đạt hiệu suất tăng đáng kể lên đến 47%.
Khách cá nhân
0828.333.363
Mr Ngọc0989.336.366
Mr Hùng0707.08.6666
Mr Hoàng089.9999.191
Mr Lộc0812.666.665
Mr Tuấn Anh09.8888.2838
Mr. Trung098.9999.192
Mr. Tuấn08.66666.166
098.33333.88
Showroom TP. Hồ Chí Minh097.9999.191
Showroom TP. Hà Nội0865.264.818
Showroom TP. Hà Nội0705.666.668
17 Hà Kế Tấn, Phường Phương Liệt, Hà Nội0765.666.668
Số 10 ngõ 95 Trần Thái Tông, Phường Cầu Giấy, Hà Nội079.9999.191
249 Lý Thường Kiệt, phường Phú Thọ, TP. Hồ Chí Minh0332.101.130
0968.929.992
Khách doanh nghiệp
097.9999.191
Mr Lực0828.333.363
Mr Ngọc0707.08.6666
Mr Hoàng