Mini PC AI GB10 chạy được mô hình nào? Tốc độ token/giây

Danh mục sản phẩm

Công nghệ

Review

Hướng dẫn

Tuyển dụng

Sự kiện

Game

Tin tức build PC

Tin tức khuyến mại

Mini PC AI GB10 chạy được mô hình nào? Tốc độ token/giây và ghép 2 máy

Trần Mạnh G 05-11-2026, 4:30 pm

Máy GB10 nạp được những mô hình rất lớn, nhưng tốc độ trả lời phụ thuộc mạnh vào kích thước mô hình. Mô hình cỡ 20 tỷ tham số cho tốc độ sinh chữ khoảng 50 token/giây theo số đo của LMSYS, mô hình 70 tỷ tham số chỉ còn khoảng 2,7 token/giây, còn mô hình Nemotron 3 Super 120B đạt khoảng 18 token/giây theo Classmethod. Bài này gom các số đo công khai để bạn hình dung máy chạy từng loại mô hình ra sao, và nói rõ chúng đo trên máy nào.

Một lưu ý trước: các số đo dưới đây do LMSYS và Classmethod thực hiện trên máy NVIDIA DGX Spark, không phải đo trên các máy MSI, Gigabyte hay ASUS bán tại Nguyễn Công PC. Vì cùng nền tảng GB10 nên có giá trị tham khảo, nhưng kết quả thực tế còn phụ thuộc phần mềm, định dạng mô hình và cách thiết lập.

Hai chỉ số cần hiểu

Khi chạy mô hình ngôn ngữ có hai giai đoạn. Giai đoạn đọc câu hỏi (prefill) cần nhiều sức tính toán nên máy GB10 làm khá tốt. Giai đoạn sinh từng chữ (decode) lại phụ thuộc vào băng thông bộ nhớ, và đây là chỗ máy bị hạn chế vì chỉ có 273 GB/s theo NVIDIA. Bạn thấy chatbot trả lời nhanh hay chậm chủ yếu là do giai đoạn thứ hai.

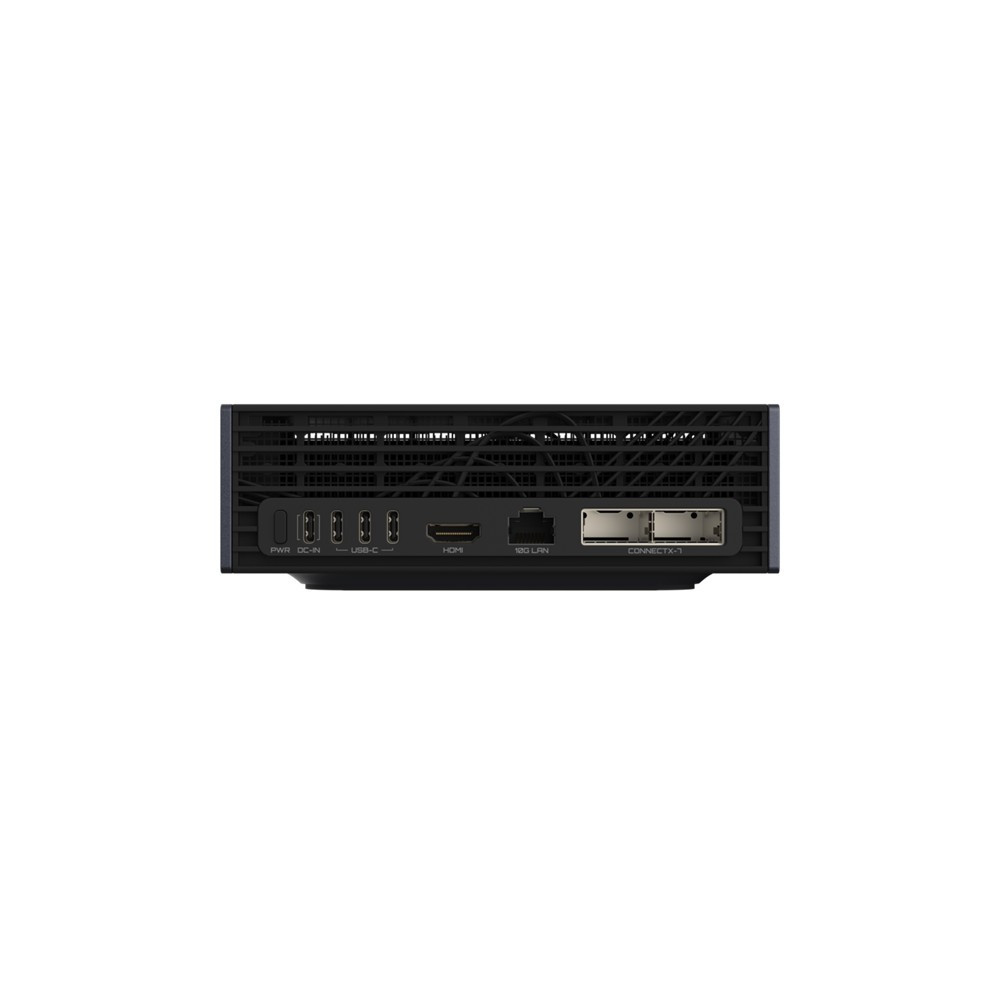
Gigabyte AI TOP ATOM ATAGB10-9000
Gigabyte AI TOP ATOM ATAGB10-9000, một trong các máy dùng nền tảng GB10

Số đo của LMSYS

LMSYS đo DGX Spark với nhiều mô hình. Bảng dưới là các số đáng chú ý, đơn vị là token/giây.

Mô hình và cách chạy Đọc câu hỏi (prefill) Sinh chữ (decode)
GPT-OSS 20B, Ollama, batch 1 2.053 49,7
Llama 3.1 8B, FP8, batch 1 7.991 20,5
Llama 3.1 8B, FP8, batch 32 7.949 368
Llama 3.1 70B, FP8, batch 1 803 2,7
DeepSeek-R1 14B, batch 8 2.074 83,5

Trong cùng bài, với GPT-OSS 20B chạy Ollama batch 1, RTX 5090 đạt khoảng 8.519 token/giây khi đọc và 205 token/giây khi sinh chữ, còn RTX PRO 6000 đạt khoảng 10.108 và 215 token/giây. Điều này khớp với việc băng thông bộ nhớ là điểm nghẽn: một card rời có băng thông cao hơn nhiều sẽ sinh chữ nhanh hơn. LMSYS cũng ghi nhận khi chạy nhiều yêu cầu cùng lúc (batch lớn hơn), tổng lượng chữ sinh ra tăng đáng kể, như mô hình 8B từ 20,5 lên 368 token/giây ở batch 32. Họ còn thử giải mã suy đoán EAGLE3 và ghi nhận tăng tới khoảng 2 lần.

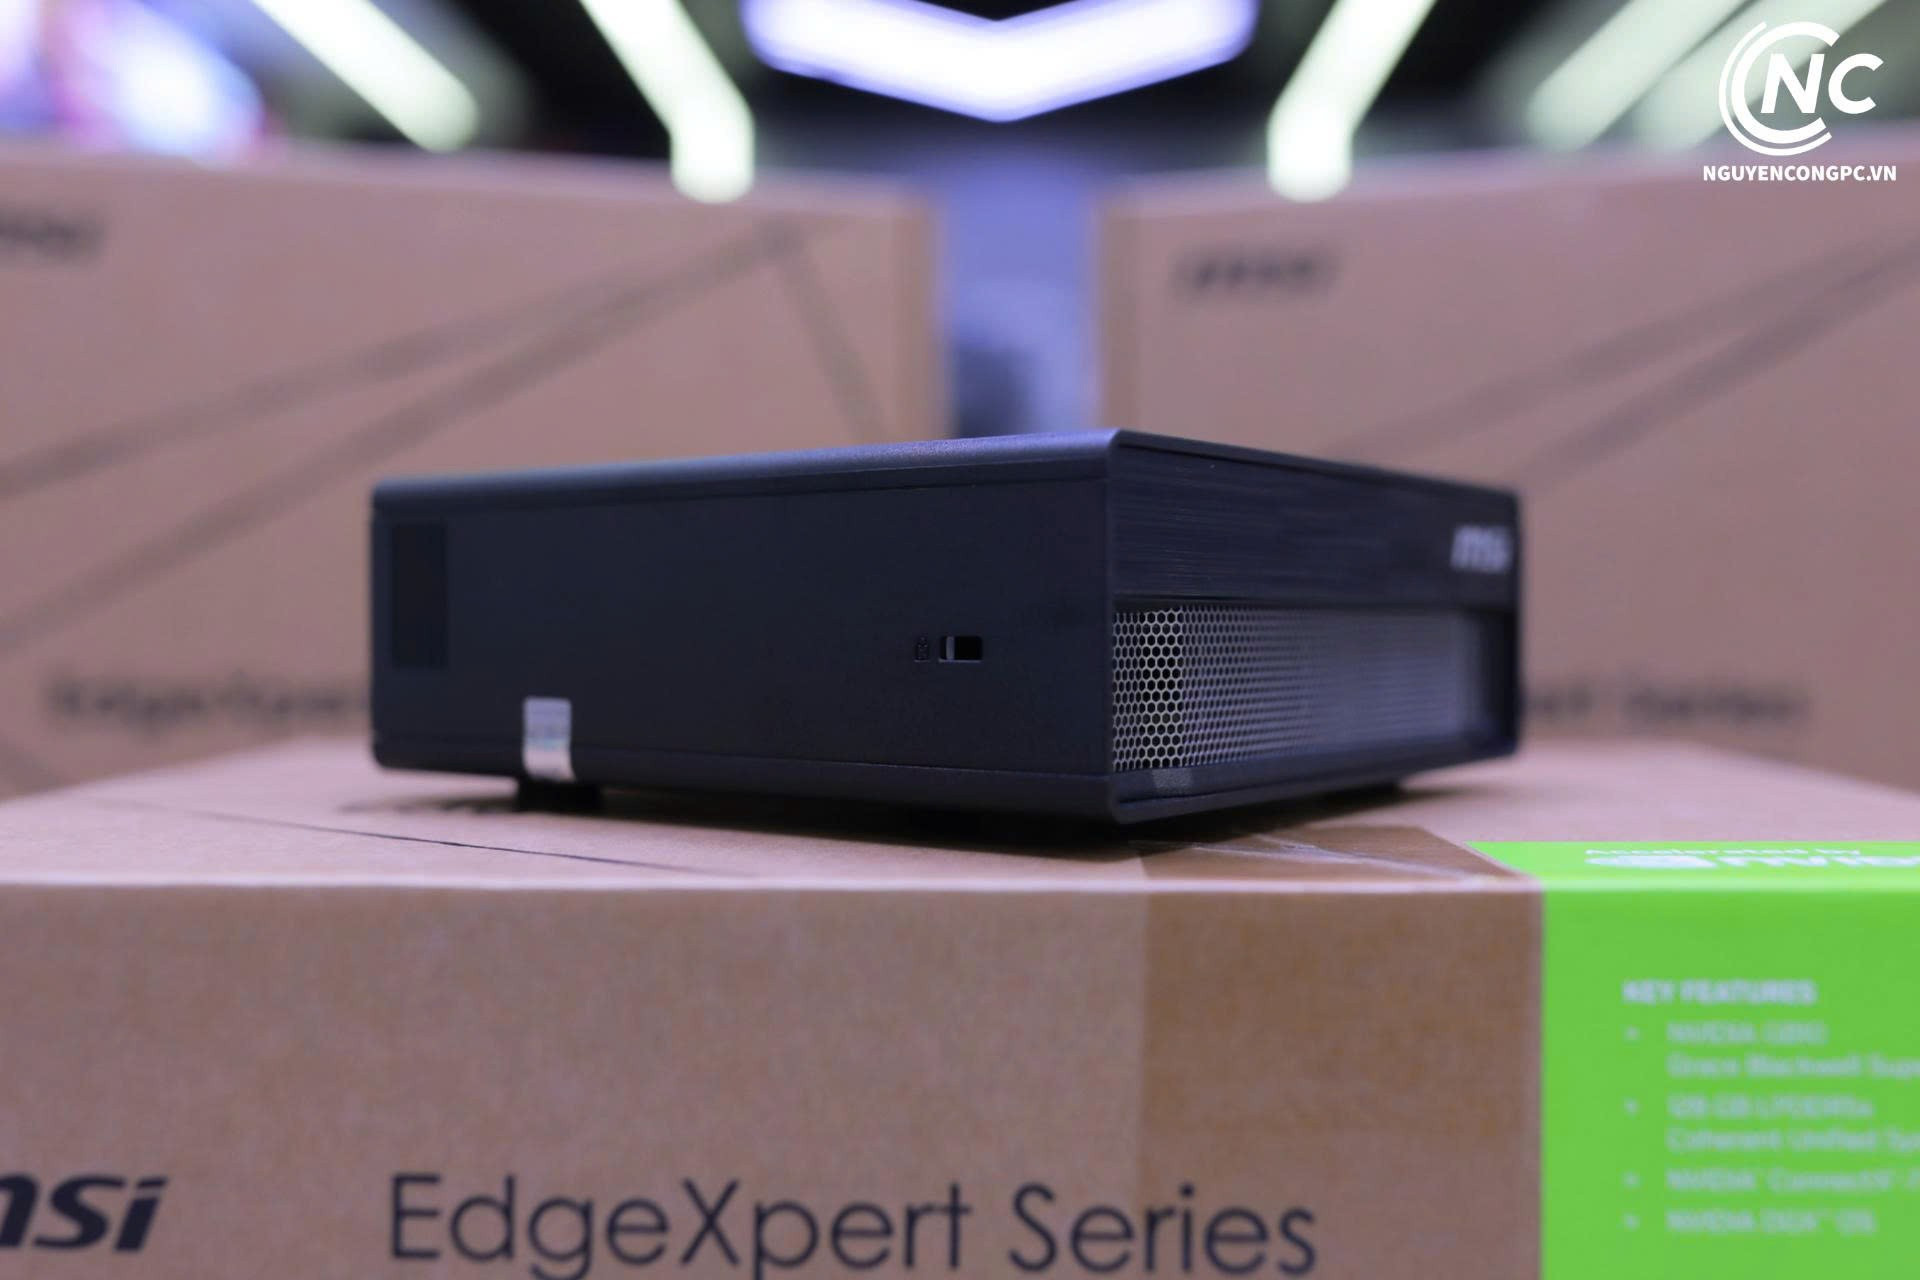
MSI EdgeXpert MS-C931 nhìn nghiêng
MSI EdgeXpert MS-C931 nhìn nghiêng, đặt trên hộp máy

Mô hình rất lớn: số đo của Classmethod

Classmethod thử các mô hình lớn hơn. Nemotron 3 Super 120B chiếm khoảng 87 GB khi nạp, đạt khoảng 112,4 token/giây khi đọc và 17,9 token/giây khi sinh chữ. Qwen3-235B đạt 15,51 token/giây trên một máy, còn 14,57 token/giây khi ghép hai máy. Devstral 2 123B trên hai máy chỉ đạt khoảng 2,64 token/giây.

Hai điều rút ra: tốc độ khác nhau rất xa giữa các mô hình, kể cả khi cùng cỡ trăm tỷ tham số, nên bạn cần xem số đo của đúng mô hình mình định chạy. Và ghép hai máy giúp nạp được mô hình lớn hơn chứ không làm tốc độ sinh chữ tăng.

Loại mô hình Mức phù hợp trên máy GB10 Ghi chú
Mô hình nhỏ đến 20B Chạy tốt, nhưng card rời nhanh hơn Máy dư bộ nhớ, thiếu băng thông
Từ 100B đến 200B Là thế mạnh của máy về dung lượng Nạp vừa 128 GB, tốc độ tùy từng mô hình (ví dụ Nemotron 3 Super 120B khoảng 17,9 token/giây)
Từ 70B trở lên Chạy được, có mô hình rất chậm Llama 3.1 70B FP8 khoảng 2,7 token/giây theo LMSYS
Tinh chỉnh đến khoảng 70B Nằm trong mức NVIDIA công bố Tốn nhiều bộ nhớ
Tạo ảnh, tạo video Chạy được nhưng cần chú ý bộ nhớ Có ca bị đứng khi sát giới hạn

Những lưu ý khi chạy thực tế

Classmethod cũng ghi lại vài vấn đề cụ thể. Mô hình tạo video Cosmos Predict 2.5 14B bị đứng máy khi chạm sát giới hạn bộ nhớ. Một số container NIM chứa file chạy dành cho x86, và thư viện CUTLASS trong vLLM chưa hỗ trợ kiến trúc sm_121 vào thời điểm họ thử. Họ cũng ghi nhận quá trình tinh chỉnh FLUX.1 bằng Dreambooth LoRA dùng khoảng 71 GB bộ nhớ GPU. Vì vậy hãy chừa khoảng trống bộ nhớ, và kiểm tra phần mềm bạn định dùng có bản cho Arm hay không.

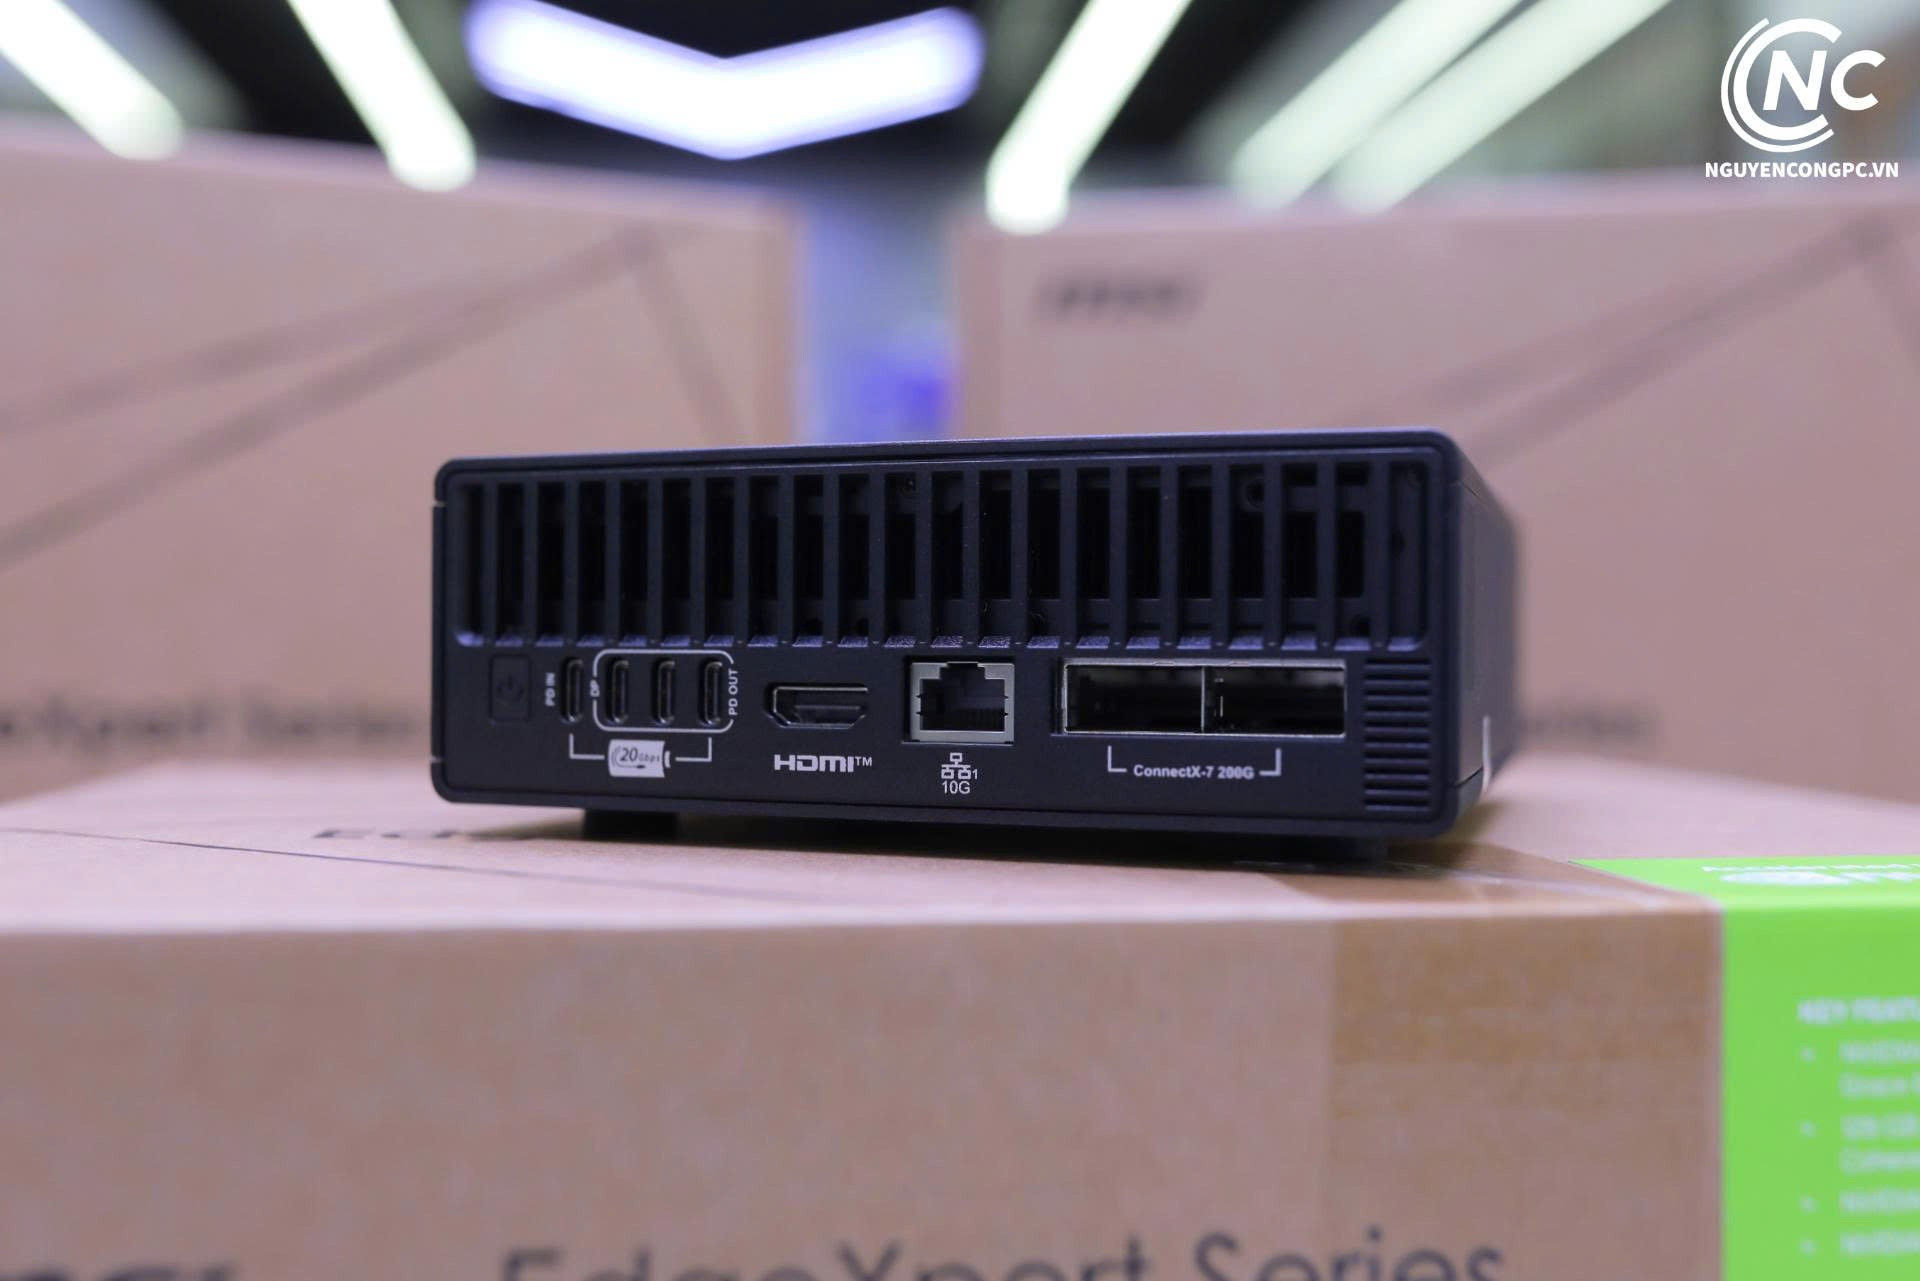
Mặt sau MSI EdgeXpert MS-C931
Mặt sau MSI EdgeXpert MS-C931 với các cổng kết nối, trong đó có cổng ConnectX-7 để ghép máy

Ghép hai máy khi nào đáng làm?

Ghép hai máy chỉ đáng khi mô hình bạn cần không nằm vừa 128 GB. Theo NVIDIA, hai máy 128 GB có tổng 256 GB, đủ cho mô hình tới khoảng 400 tỷ tham số, còn bốn máy lên 512 GB nhưng cần thêm switch 200 GbE. Nếu mô hình đã nằm vừa một máy, bạn không có lợi gì về tốc độ khi mua thêm máy thứ hai. Bạn có thể xem MSI EdgeXpert MS-C931, Gigabyte AI TOP ATOM ATAGB10-9000 hoặc ASUS Ascent GX10 để chọn máy, và xem bài DGX Spark là gì nếu muốn hiểu thêm về chip.

Câu hỏi thường gặp

Máy GB10 chạy được mô hình nào?

Theo NVIDIA, suy luận tới khoảng 200 tỷ tham số trên một máy. Số đo công khai có GPT-OSS 20B, Llama 3.1, DeepSeek-R1 14B, Nemotron 3 Super 120B và Qwen3-235B.

Chạy GPT-OSS 20B được bao nhiêu token/giây?

Theo LMSYS, khoảng 49,7 token/giây khi sinh chữ với Ollama batch 1 trên DGX Spark.

Chạy Llama 70B được không?

Được nhưng chậm. LMSYS đo Llama 3.1 70B ở FP8 batch 1 khoảng 2,7 token/giây khi sinh chữ.

Vì sao sinh chữ lại chậm?

Giai đoạn này phụ thuộc vào băng thông bộ nhớ, trong khi máy có 273 GB/s, thấp hơn nhiều so với card rời cao cấp.

Chạy nhiều yêu cầu cùng lúc có tốt hơn không?

Có. LMSYS ghi nhận với Llama 3.1 8B, batch 32 cho khoảng 368 token/giây tổng so với 20,5 ở batch 1.

Ghép hai máy có nhanh hơn không?

Không. Classmethod đo Qwen3-235B là 15,51 token/giây trên một máy và 14,57 khi ghép hai máy.

Mô hình càng lớn thì càng chậm phải không?

Nhìn chung là vậy, nhưng không đều. Theo Classmethod, Nemotron 3 Super 120B đạt khoảng 17,9 token/giây còn Devstral 2 123B trên hai máy chỉ khoảng 2,64 token/giây, nên cần xem số đo đúng mô hình bạn định dùng.

Số đo này có áp dụng cho máy MSI, Gigabyte, ASUS không?

Số đo trên DGX Spark. Các hãng dùng chung nền tảng GB10 nên có giá trị tham khảo, nhưng kết quả thực tế còn tùy phần mềm và thiết lập.

Máy tạo ảnh hoặc video được không?

Được, nhưng cần chú ý giới hạn bộ nhớ. Classmethod ghi nhận một mô hình tạo video 14B bị đứng khi sát giới hạn.

Tinh chỉnh mô hình được cỡ nào?

Theo NVIDIA, tới khoảng 70 tỷ tham số trên máy 128 GB.

Phần mềm nào chưa chạy được?

Classmethod ghi một số container NIM có file x86 và vLLM CUTLASS chưa hỗ trợ sm_121 vào thời điểm họ thử. Tình trạng này có thể đã thay đổi theo thời gian.

Máy có đáng mua nếu chỉ chạy mô hình nhỏ?

Thường không, vì card rời hoặc bộ PC AI sẽ nhanh hơn và rẻ hơn cho mô hình nhỏ.

Bài viết liên quan

MIL-STD-810H là gì? Hiểu đúng về laptop độ bền chuẩn quân sự

MIL-STD-810H là gì? Hiểu đúng về laptop độ bền chuẩn quân sự

08-11-2026, 3:03 pm

MIL-STD-810H là bộ phương pháp thử nghiệm môi trường, không phải chứng nhận của quân đội. Bài viết giải thích các hạng mục thử trên laptop, hiểu lầm thường gặp và cách đọc thông số khi chọn mua.

Card đồ họa chạy DeepSeek: cần bao nhiêu VRAM và chọn dòng RTX nào?

Card đồ họa chạy DeepSeek: cần bao nhiêu VRAM và chọn dòng RTX nào?

07-11-2026, 2:54 pm

Card đồ họa chạy DeepSeek cần bao nhiêu VRAM? Dung lượng từng bản DeepSeek-R1, card RTX 5060 đến RTX 5090 phù hợp bản nào, DeepSeek V4 có chạy được không và gợi ý bộ PC.

Đánh giá Acer Nitro ProPanel ANV16-I12-53VH: Sự kết hợp giữa hiệu năng và trải nghiệm hình ảnh cùng diện mạo mới

Đánh giá Acer Nitro ProPanel ANV16-I12-53VH: Sự kết hợp giữa hiệu năng và trải nghiệm hình ảnh cùng diện mạo mới

07-11-2026, 2:22 pm

Đánh giá Acer Nitro ProPanel ANV16-I12-53VH (Nitro V 16): Core 5 205H, RTX 3050 4GB, màn 16 inch 16:10 165Hz, điểm benchmark, so sánh với ANV15-52-50VA và ai nên chọn.

PC gaming Core Ultra: chọn Ultra 7 265K, 270K Plus hay Ultra 9 285K

PC gaming Core Ultra: chọn Ultra 7 265K, 270K Plus hay Ultra 9 285K

07-11-2026, 10:57 am

So sánh Core Ultra 7 265K, 265KF, 270K Plus và Core Ultra 9 285K theo thông số Intel, cách ghép card đồ họa, RAM và 8 bộ PC gaming Core Ultra có cấu hình chi tiết.

PC Gaming Core i7: i7-14700F hợp card nào và khi nào đáng chọn?

PC Gaming Core i7: i7-14700F hợp card nào và khi nào đáng chọn?

07-11-2026, 9:07 am

So sánh Core i7-14700F với Core i5 theo thông số Intel, gợi ý khi nào đáng chọn Core i7 và điểm qua 5 bộ Core i7 có ảnh chụp thật.

PC Gaming Core i5: chọn 12400F, 14400F hay 14600K/KF?

PC Gaming Core i5: chọn 12400F, 14400F hay 14600K/KF?

06-11-2026, 4:39 pm

So sánh ba mã Core i5 trong PC gaming theo thông số Intel, gợi ý khi nào chọn mã nào và điểm qua 8 bộ Core i5 có ảnh chụp thật.

MSI EdgeXpert vs Gigabyte AI TOP ATOM vs ASUS Ascent GX10: chọn máy nào

MSI EdgeXpert vs Gigabyte AI TOP ATOM vs ASUS Ascent GX10: chọn máy nào

05-11-2026, 3:15 pm

So sánh ba mini PC AI dùng chip GB10: MSI EdgeXpert MS-C931, Gigabyte AI TOP ATOM ATAGB10-9000 và ASUS Ascent GX10 theo SSD, cổng kết nối, cân nặng và nhu cầu sử dụng.

DGX Spark là gì? Chip GB10, thông số và ai nên mua

DGX Spark là gì? Chip GB10, thông số và ai nên mua

05-11-2026, 3:14 pm

DGX Spark là máy tính AI để bàn của NVIDIA dùng chip GB10 với 128 GB bộ nhớ dùng chung. Bài giải thích chip, thông số, việc máy làm được và ai nên mua.

Có nên mua mini PC AI GB10 không? Những điều cần biết trước khi quyết định

Có nên mua mini PC AI GB10 không? Những điều cần biết trước khi quyết định

05-11-2026, 3:10 pm

Mini PC AI GB10 hợp với ai và không hợp với ai? Bài này đi qua 128 GB bộ nhớ, băng thông 273 GB/s, chip Arm, Linux và cách chọn giữa MSI EdgeXpert, Gigabyte AI TOP ATOM, ASUS Ascent GX10.

PC AI cho Data Analyst: chọn CPU, RAM và GPU theo khối lượng dữ liệu

PC AI cho Data Analyst: chọn CPU, RAM và GPU theo khối lượng dữ liệu

05-11-2026, 2:38 pm

PC AI cho Data Analyst nên ưu tiên RAM trước, rồi SSD NVMe và CPU nhiều nhân; GPU chỉ cần khi chạy cuDF hoặc mô hình AI cục bộ. Bài gợi ý cấu hình theo khối lượng dữ liệu và bốn bộ PC AI tại Nguyễn Công PC.

VRR là gì? Tần số quét biến thiên giúp game mượt hơn như thế nào

VRR là gì? Tần số quét biến thiên giúp game mượt hơn như thế nào

04-11-2026, 3:21 pm

VRR (tần số quét biến thiên) cho màn hình đổi tần số quét theo số khung hình card đồ họa xuất ra, giúp giảm xé hình và giật khi FPS lên xuống. Bài giải thích cách hoạt động, khác biệt với FreeSync, G-SYNC và cách bật trên PC.

RX 9070 XT game benchmark: FPS thực tế ở 1080p, 1440p và 4K

RX 9070 XT game benchmark: FPS thực tế ở 1080p, 1440p và 4K

04-11-2026, 2:06 pm

RX 9070 XT đạt trung bình 81 FPS ở 4K trong bài thử 52 game của TechSpot và chỉ kém RTX 5070 Ti 2 FPS ở 1440p. Bài này tổng hợp FPS theo từng game, ray tracing và các bộ PC đi kèm.

mes
Chat Facebook(8h-22h30)
mes
Chat Zalo(8h-22h30)
Laptop MEGA Sale

Thêm sản phẩm vào giỏ hàng thành công!