RTX Spark 128GB, RTX 5090 hay Mac M5 Max chạy LLM local?

Danh mục sản phẩm

Công nghệ

Review

Hướng dẫn

Tuyển dụng

Sự kiện

Game

Tin tức build PC

Tin tức khuyến mại

RTX Spark 128GB, RTX 5090 hay Mac M5 Max: chọn máy nào chạy LLM local?

Trần Mạnh 02-11-2026, 11:00 am

Nếu model của bạn lớn hơn VRAM của một card rời, laptop RTX Spark 128GB như ASUS ProArt P16 H7607BA-SE343W là lựa chọn dễ chạy trọn model trên GPU. Nếu model vừa trong VRAM và bạn cần tốc độ sinh chữ cao nhất, RTX 5090 thường nhanh hơn. Còn nếu bạn làm việc trong môi trường Apple (MLX, Metal), MacBook Pro M5 Max 128GB là cùng phân khúc sức chứa. Dưới đây là số liệu đã đo trên máy của Nguyễn Công PC và các số tham khảo từ nguồn khác để bạn tự đối chiếu.

ASUS ProArt P16 H7607BA-SE343W mở màn hình đặt trên bàn
Mặt trước và màn hình OLED 16 inch
Cầm ASUS ProArt P16 mở màn hình tại cửa hàng Nguyễn Công PC
Cầm máy mở màn hình tại cửa hàng
Mặt lưng màu trắng có logo ProArt của ASUS ProArt P16
Mặt lưng màu trắng có logo ProArt

Hai thứ cần phân biệt: sức chứa và tốc độ

Khi chạy LLM trên máy cá nhân có hai câu hỏi tách biệt. Câu thứ nhất là model có nạp vừa vào bộ nhớ không. Câu thứ hai là nạp vừa rồi thì máy sinh chữ nhanh đến đâu. Máy có nhiều bộ nhớ trả lời tốt câu thứ nhất, còn băng thông bộ nhớ, kiến trúc model và phần mềm chạy ảnh hưởng nhiều đến câu thứ hai.

Vì thế so sánh "máy nào mạnh hơn" mà không nói cỡ model là chưa đủ. Chúng ta nên chia theo cỡ model.

Nền tảng Bộ nhớ Băng thông peak Với model 80B Q8 (khoảng 84,81GB)
ProArt P16 RTX Spark N1X 128GB hợp nhất 300,8GB/s (suy tính, chưa đo thực tế) Đã chạy 49/49 layer CUDA trên máy mẫu
MacBook Pro M5 Max 40 GPU Tùy chọn 128GB hợp nhất 614GB/s Cùng phân khúc sức chứa; chúng tôi chưa tự đo cùng model/quant
RTX 5090 Laptop 24GB GDDR7 896GB/s Weights không nằm trọn trong VRAM của một GPU
RTX 5090 desktop 32GB GDDR7 1.792GB/s Weights không nằm trọn trong VRAM của một GPU

Con số 300,8GB/s của RTX Spark là tính từ 9.400 MT/s × 256 bit ÷ 8, chưa phải băng thông đo thực tế. Bộ nhớ hợp nhất do CPU và GPU dùng chung, nên dung lượng dành cho model còn phải trừ KV cache, buffer và phần hệ điều hành.

Model lớn hơn VRAM: RTX Spark 128GB có lợi thế

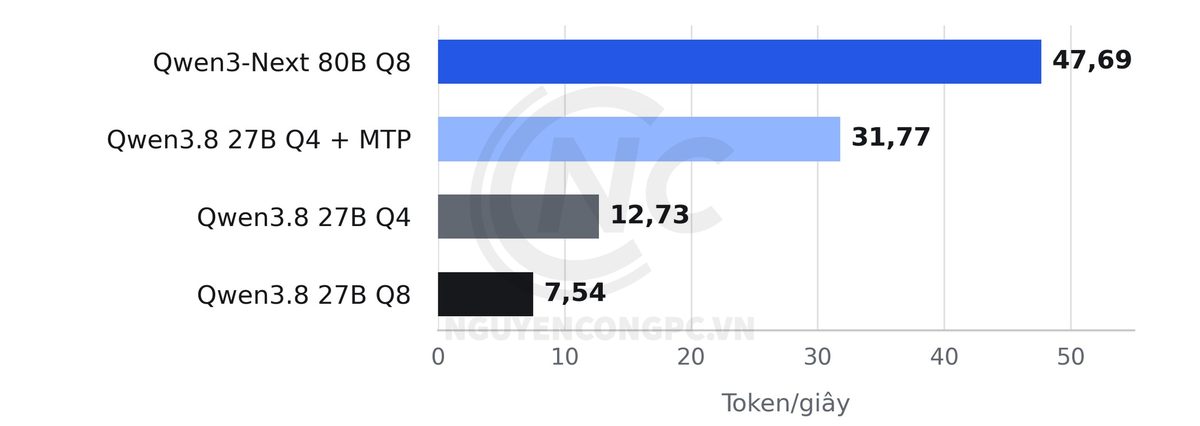
Trong bài benchmark của Nguyễn Công PC, model Qwen3-Next-80B-A3B-Instruct bản Q8_0 (84,81GB weights) chạy toàn bộ 49/49 layer trên GPU, đạt 47,69 token/giây và thời gian tới token đầu tiên khoảng 0,47 giây. Cả RTX 5090 Laptop (24GB) lẫn bản desktop (32GB) đều không chứa trọn weights này trong VRAM. Card rời vẫn có thể chạy model đó bằng cách đẩy bớt sang CPU, giảm quant hoặc ghép nhiều GPU, nhưng thời gian và chất lượng phải đo lại theo từng cách, và chúng tôi chưa có số đo cùng điều kiện. Chi tiết bài benchmark này ở bài chạy model AI 80B trên ProArt P16 RTX Spark.

Model vừa VRAM: RTX 5090 nhanh hơn

Ở nhóm 4-bit của họ model Qwen3.8 27B, các số tham khảo cho thấy chênh lệch khá rõ. Cần lưu ý weights, runtime và cách đo của từng nguồn khác nhau, nên đây là bối cảnh tham khảo chứ không phải phép so sánh công bằng.

Nền tảng Model và runtime Token/giây Điều kiện
RTX Spark 128GB (Nguyễn Công PC đo) GGUF Q4_K_M, native 2.65.0 12,73 512/128, 4 slot, trung vị 3 lượt
RTX Spark 128GB + MTP (Nguyễn Công PC đo) GGUF Q4_K_M + MTP, native 2.65.0 31,77 512/128, 1 slot, trung vị 3 lượt
MacBook Pro M5 Max 128GB GGUF Q4_K_M, LM Studio 26,3 Số trung bình của bộ benchmark GAUNTLET, chưa nêu MTP
Mac M5 Max 40 GPU 64GB MLX 4-bit, oMLX 0.7.0 32,9 Context 1K, MTP/DFlash tắt, máy 64GB
RTX 5090 Laptop 24GB GGUF UD-Q4_K_M, llama.cpp 40,86 pp512/tg128, giới hạn 95W, không MTP
RTX 5090 desktop 32GB GGUF Q4_K_M, llama.cpp 78,9 tg128, context ngắn, chưa nêu MTP
Biểu đồ tốc độ sinh token trên ASUS ProArt P16 RTX Spark
Tốc độ decode đo trên máy mẫu ProArt P16 RTX Spark 128GB, đơn vị token/giây

Hai dòng RTX Spark khác nhau cả MTP lẫn số slot, nên bạn đừng đọc thành "MTP nhanh gấp 2,5 lần". Điều có thể nói là: với model vừa VRAM, card 5090 desktop đang cho số cao nhất trong bảng, còn RTX Spark và Mac M5 Max nằm gần nhau ở nhóm giữa.

Một bài review khác cho thấy lợi thế đổi theo tác vụ

Review của Matthew Moniz đặt ProArt P16 RTX Spark cạnh MacBook Pro M5 Max 128GB trên ba bài:

Bài benchmark ProArt P16 RTX Spark MacBook Pro M5 Max 128GB
FLUX, giây mỗi ảnh 24 53
LLM 27B sustained sau 10 phút, token/giây 16,5 24
Model 120B kèm tài liệu dài, tổng số giây 42 52

ProArt có thời gian ngắn hơn ở bài FLUX và bài tài liệu dài, trong khi Mac có tốc độ decode 27B cao hơn. Review này chưa nêu đủ model, quant và workflow để tái lập, và không nên ghép tỷ lệ với số đo máy mẫu của chúng tôi.

CUDA hay Metal: phần mềm của bạn quyết định nhiều hơn

Ngoài số token mỗi giây, bạn còn phải nghĩ tới hệ sinh thái. Nếu bạn cần CUDA (nhiều công cụ AI, ComfyUI, runtime NVIDIA) và muốn mang theo máy, ProArt RTX Spark đáp ứng, dù trên Windows on Arm vẫn có các lỗi cài đặt cần xử lý như bài kiểm tra phần mềm trước khi mua laptop RTX Spark đã nói. Nếu bạn đã quen MLX và Metal thì Mac 128GB là hướng đối chiếu hợp lý. Còn nếu cần throughput tối đa cho model vừa VRAM và không cần mang đi, một cấu hình desktop với RTX 5090 sẽ đáng đưa vào so sánh.

Màn hình ASUS ProArt P16 đang hiển thị phần mềm đồ họa dạng node
Màn hình đang chạy phần mềm đồ họa
Bàn phím ASUS ProArt P16 với nhãn NVIDIA RTX Spark
Bàn phím có nhãn NVIDIA RTX Spark
Cạnh bên ASUS ProArt P16 có khe thẻ SD, cổng USB-A và USB-C
Cạnh bên có khe thẻ nhớ và cổng kết nối

Chọn máy nào theo nhu cầu?

Ưu tiên của bạn Hướng chọn Gợi ý
Chạy model lớn hơn VRAM, cần CUDA, vừa đi vừa dùng ProArt RTX Spark 128GB Xem ASUS ProArt P16 H7607BA-SE343W hoặc laptop NVIDIA RTX Spark
Tốc độ cao nhất cho model vừa VRAM, đặt cố định Desktop RTX 5090 Xem RTX 5090 và bộ PC chạy AI
Chạy agent AI thường trực Máy chạy liên tục, không phải laptop Xem Agent Computer
Dùng MLX và Metal Mac 128GB Đối chiếu với ứng dụng và quant của bạn
Làm workstation đồ họa kèm AI Tùy phần mềm Xem laptop workstation hoặc PC workstation

Những gì chúng tôi chưa đo

  • RTX 5090 và Mac M5 Max cùng model, cùng quant, cùng runtime với RTX Spark.
  • Tốc độ chạy 80B Q8 khi RTX 5090 phải offload sang CPU.
  • Băng thông bộ nhớ đo thực tế (300,8GB/s là số suy tính).
  • Pin, tiếng ồn, điện năng, chế độ OEM Performance.
  • Mức giá và giá trị theo giá bán.

RTX Spark 128GB có chạy LLM nhanh hơn RTX 5090 không?

Không phải lúc nào cũng vậy. Với model lớn hơn VRAM của card rời, RTX Spark có lợi thế vì chứa trọn model. Với model vừa VRAM, các số tham khảo cho thấy RTX 5090 nhanh hơn rõ, ví dụ model 27B 4-bit: 40,86 token/giây trên RTX 5090 Laptop và 78,9 trên bản desktop, so với 12,73 đến 31,77 trên RTX Spark.

Vì sao RTX 5090 không chạy trọn model 80B Q8?

Weights của Qwen3-Next 80B Q8 khoảng 84,81GB, trong khi RTX 5090 Laptop có 24GB VRAM và bản desktop có 32GB. Bạn vẫn có thể chạy bằng offload sang CPU, giảm quant hoặc dùng nhiều GPU, nhưng cần đo lại tốc độ và chất lượng.

MacBook Pro M5 Max 128GB so với ProArt P16 RTX Spark thế nào?

Cùng phân khúc sức chứa 128GB bộ nhớ hợp nhất. Băng thông của M5 Max (614GB/s) cao hơn con số suy tính của RTX Spark (300,8GB/s). Trong review của Matthew Moniz, ProArt nhanh hơn ở FLUX và bài tài liệu dài, còn Mac decode model 27B nhanh hơn. Chúng tôi chưa tự đo Mac.

Băng thông bộ nhớ ảnh hưởng thế nào đến tốc độ chạy LLM?

Băng thông là một yếu tố ảnh hưởng tới throughput, cùng với kiến trúc model, runtime và workload. Vì vậy bạn không nên chỉ nhìn băng thông để dự đoán tốc độ.

Model MoE có chạy nhanh hơn model dense không?

Với model MoE như Qwen3-Next 80B-A3B, mỗi token chỉ kích hoạt khoảng 3 tỷ tham số trong tổng 80 tỷ, nên không nên suy từ số tham số tổng sang khối lượng tính toán như model dense cùng cỡ.

Chạy được model 120B trên ProArt P16 không?

Trong bài benchmark của chúng tôi, model lớn nhất đã chạy là 80B Q8. Mốc 120B và context 1 triệu token chưa được kiểm tra. Review của Matthew Moniz có bài 120B kèm tài liệu dài nhưng chưa nêu đủ thông tin để tái lập.

Nên mua laptop hay PC để chạy LLM local?

Nếu bạn cần mang đi và cần CUDA với model lớn thì laptop RTX Spark 128GB đáng xem. Nếu đặt cố định và cần tốc độ cao với model vừa VRAM thì PC RTX 5090 thường hợp hơn. Nếu chạy agent thường trực thì nên xem máy chuyên dụng.

MTP là gì và có làm model chạy nhanh hơn không?

Trong bài benchmark, cấu hình 27B Q4_K_M có MTP đạt 31,77 token/giây (1 slot), còn không MTP đạt 12,73 token/giây (4 slot). Hai cấu hình khác số slot nên chưa thể quy riêng mức tăng cho MTP.

128GB bộ nhớ hợp nhất có dùng hết cho model được không?

Không. Dung lượng dành cho model còn phải chia cho KV cache, buffer, hệ điều hành và các tác vụ khác. Trong bài benchmark, máy có GPU reservation 64GiB và CUDA budget khoảng 94,48GiB cùng nằm trong bộ nhớ hợp nhất.

Có nâng cấp RAM cho ProArt P16 RTX Spark được không?

Không. ASUS ghi RAM LPDDR5X gắn liền bo mạch, tối đa 128GB, nên bạn phải chọn dung lượng ngay khi mua.

Số liệu trong bài có đáng tin để quyết định mua không?

Nên dùng để định hướng. Số của RTX Spark là đo trên một máy mẫu ở chế độ Windows Standard khi cắm điện, còn các nền tảng khác là số tham khảo từ nguồn công bố, khác weights, runtime và giao thức. Bạn nên thử với model và phần mềm của mình trước khi quyết định.

Bài viết liên quan

MIL-STD-810H là gì? Hiểu đúng về laptop độ bền chuẩn quân sự

MIL-STD-810H là gì? Hiểu đúng về laptop độ bền chuẩn quân sự

08-11-2026, 3:03 pm

MIL-STD-810H là bộ phương pháp thử nghiệm môi trường, không phải chứng nhận của quân đội. Bài viết giải thích các hạng mục thử trên laptop, hiểu lầm thường gặp và cách đọc thông số khi chọn mua.

Card đồ họa chạy DeepSeek: cần bao nhiêu VRAM và chọn dòng RTX nào?

Card đồ họa chạy DeepSeek: cần bao nhiêu VRAM và chọn dòng RTX nào?

07-11-2026, 2:54 pm

Card đồ họa chạy DeepSeek cần bao nhiêu VRAM? Dung lượng từng bản DeepSeek-R1, card RTX 5060 đến RTX 5090 phù hợp bản nào, DeepSeek V4 có chạy được không và gợi ý bộ PC.

Đánh giá Acer Nitro ProPanel ANV16-I12-53VH: Sự kết hợp giữa hiệu năng và trải nghiệm hình ảnh cùng diện mạo mới

Đánh giá Acer Nitro ProPanel ANV16-I12-53VH: Sự kết hợp giữa hiệu năng và trải nghiệm hình ảnh cùng diện mạo mới

07-11-2026, 2:22 pm

Đánh giá Acer Nitro ProPanel ANV16-I12-53VH (Nitro V 16): Core 5 205H, RTX 3050 4GB, màn 16 inch 16:10 165Hz, điểm benchmark, so sánh với ANV15-52-50VA và ai nên chọn.

PC gaming Core Ultra: chọn Ultra 7 265K, 270K Plus hay Ultra 9 285K

PC gaming Core Ultra: chọn Ultra 7 265K, 270K Plus hay Ultra 9 285K

07-11-2026, 10:57 am

So sánh Core Ultra 7 265K, 265KF, 270K Plus và Core Ultra 9 285K theo thông số Intel, cách ghép card đồ họa, RAM và 8 bộ PC gaming Core Ultra có cấu hình chi tiết.

PC Gaming Core i7: i7-14700F hợp card nào và khi nào đáng chọn?

PC Gaming Core i7: i7-14700F hợp card nào và khi nào đáng chọn?

07-11-2026, 9:07 am

So sánh Core i7-14700F với Core i5 theo thông số Intel, gợi ý khi nào đáng chọn Core i7 và điểm qua 5 bộ Core i7 có ảnh chụp thật.

PC Gaming Core i5: chọn 12400F, 14400F hay 14600K/KF?

PC Gaming Core i5: chọn 12400F, 14400F hay 14600K/KF?

06-11-2026, 4:39 pm

So sánh ba mã Core i5 trong PC gaming theo thông số Intel, gợi ý khi nào chọn mã nào và điểm qua 8 bộ Core i5 có ảnh chụp thật.

Tạo ảnh, video AI ngay trên laptop: FLUX, Qwen Image, Wan 2.2 trên ProArt P16 RTX Spark mất bao lâu?

Tạo ảnh, video AI ngay trên laptop: FLUX, Qwen Image, Wan 2.2 trên ProArt P16 RTX Spark mất bao lâu?

02-11-2026, 9:58 am

Nguyễn Công PC benchmark tạo ảnh và video AI trên ASUS ProArt P16 RTX Spark 128GB: FLUX, Qwen Image, Wan2.2 mất bao lâu, clip 4K60 thực chất được upscale từ 1280 × 704, và những lỗi phần mềm cần biết.

Hướng dẫn cài đặt Unsloth trên Windows từng bước chi tiết

Hướng dẫn cài đặt Unsloth trên Windows từng bước chi tiết

02-11-2026, 9:47 am

Cài Unsloth trên Windows 10 hoặc 11 không cần WSL: có card NVIDIA đã cài driver, chạy lệnh PowerShell của Studio rồi mở 127.0.0.1:8888. Bài hướng dẫn 3 cách cài (Desktop, Studio, Conda), bảng VRAM để fine-tune, xuất model sang GGUF và sửa lỗi thường gặp.

Chạy model AI 80B trên laptop: ASUS ProArt P16 RTX Spark 128GB benchmark Qwen3-Next 80B

Chạy model AI 80B trên laptop: ASUS ProArt P16 RTX Spark 128GB benchmark Qwen3-Next 80B

02-11-2026, 9:37 am

ASUS ProArt P16 RTX Spark 128GB nạp được Qwen3-Next 80B Q8 (khoảng 84,81GB) chạy toàn bộ layer trên GPU, 47,69 token/giây, vượt VRAM của RTX 5090. Bài benchmark của Nguyễn Công PC, so với RTX 5090 và Mac M5 Max, lỗi phần mềm và giới hạn của bài benchmark.

Modern Warfare 4 Season 1 Ra Mắt Ngày 6/11: Map, Chế Độ, Súng Mới Và Cấu Hình PC Để Chơi

Modern Warfare 4 Season 1 Ra Mắt Ngày 6/11: Map, Chế Độ, Súng Mới Và Cấu Hình PC Để Chơi

29-10-2026, 10:29 am

Modern Warfare 4 Season 1 ra mắt ngày 6/11 với map Backstab, Canyon, Shoot House, khu DMZ X01, hai map Warzone, súng Cronen Osprey, CSG-35 và cấu hình PC đề nghị để chơi mượt.

Acer Swift Air 14 pin 70 Wh dùng được bao lâu? Cách đọc con số 19 giờ của Acer

Acer Swift Air 14 pin 70 Wh dùng được bao lâu? Cách đọc con số 19 giờ của Acer

28-10-2026, 5:41 pm

Acer công bố pin 70 Wh của Swift Air 14 chạy tối đa 19 giờ xem video và 16 giờ duyệt web; hai bài đo độc lập ghi khoảng 22,5 giờ. Bài giải thích điều kiện đo, cách ước lượng khi dùng thật và mẹo kéo dài pin.

Acer Swift Air 14 hay MacBook Neo: chọn máy nào cho học tập và văn phòng

Acer Swift Air 14 hay MacBook Neo: chọn máy nào cho học tập và văn phòng

28-10-2026, 5:40 pm

So sánh Acer Swift Air 14 (Core 5 320, 120 Hz, pin 70 Wh) với MacBook Neo (A18 Pro, màn 13 inch 219 ppi) qua thông số hãng và số đo độc lập. MacBook Neo nhanh hơn về điểm số; Swift Air 14 hơn về pin, cổng kết nối và màn hình 120 Hz.

mes
Chat Facebook(8h-22h30)
mes
Chat Zalo(8h-22h30)
Laptop MEGA Sale

Thêm sản phẩm vào giỏ hàng thành công!