Local AI, Cloud AI và Hybrid AI: doanh nghiệp và cá nhân nên chọn giải pháp nào?
Hoài Anh05-11-2026, 3:37 pm
Cá nhân chỉ hỏi đáp, viết hay dịch thỉnh thoảng thường chọn Cloud AI là đủ. Người dùng AI hằng ngày hoặc xử lý dữ liệu nhạy cảm nên cân nhắc Local AI. Phần lớn doanh nghiệp sẽ hợp với Hybrid AI hơn, vì vừa cần mô hình mạnh trên đám mây vừa cần giữ một phần dữ liệu trong nhà. Đây là nhận định dựa trên các nguồn của Qualcomm, NVIDIA, OpenAI, Microsoft và EY trong bài.
Local AI là mô hình chạy ngay trên máy của bạn hoặc máy chủ nội bộ. Cloud AI là dịch vụ chạy trên hạ tầng của nhà cung cấp và bạn gọi qua internet. Hybrid AI chia việc giữa hai bên, theo mô tả của Qualcomm là đặt mỗi phép tính ở nơi chạy tốt nhất (bản trắng công bố tháng 5/2023). Bài này so sánh ba hướng theo dữ liệu, chi phí, độ trễ và phần cứng để bạn chọn đúng.
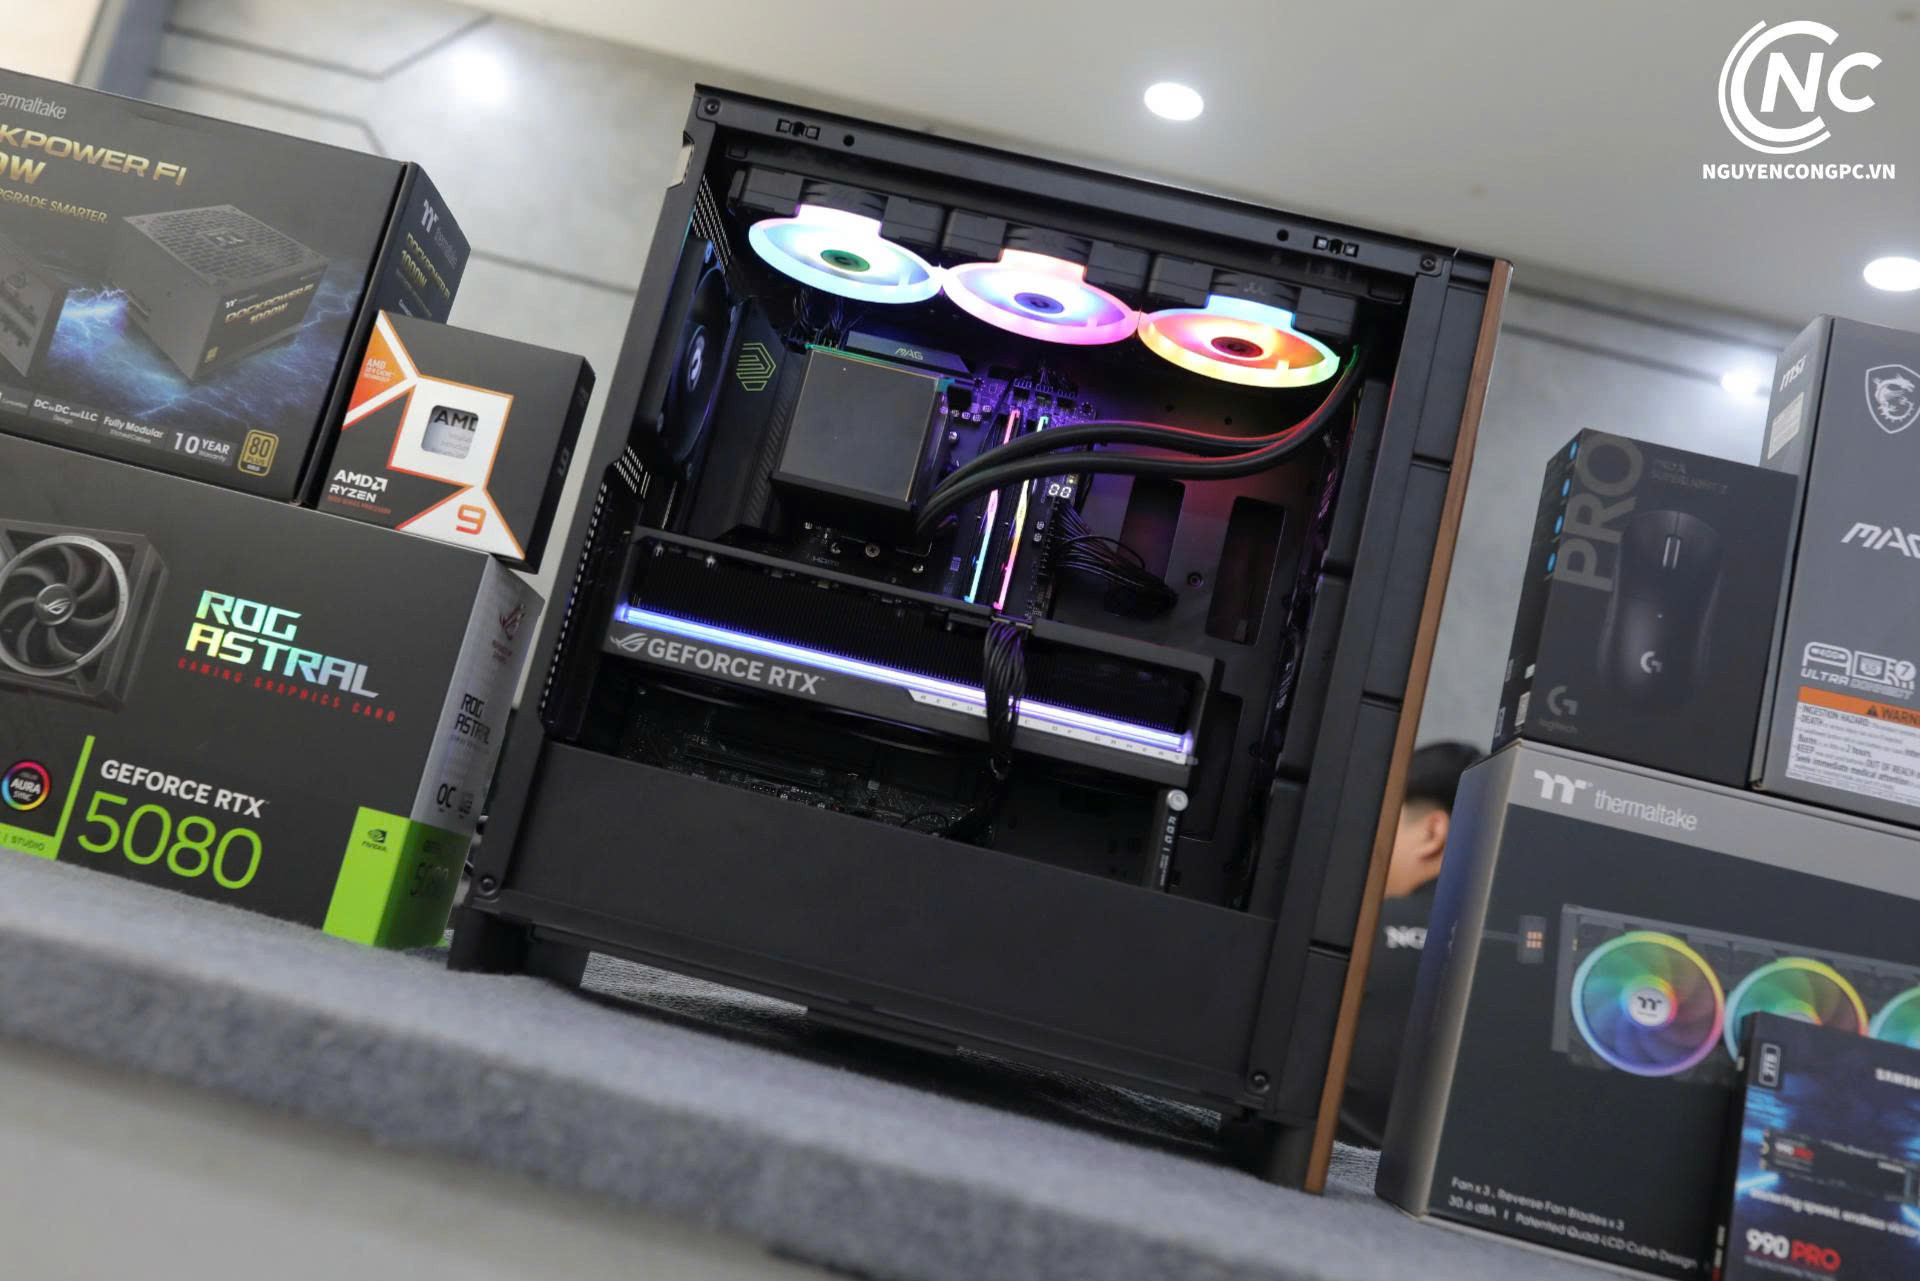
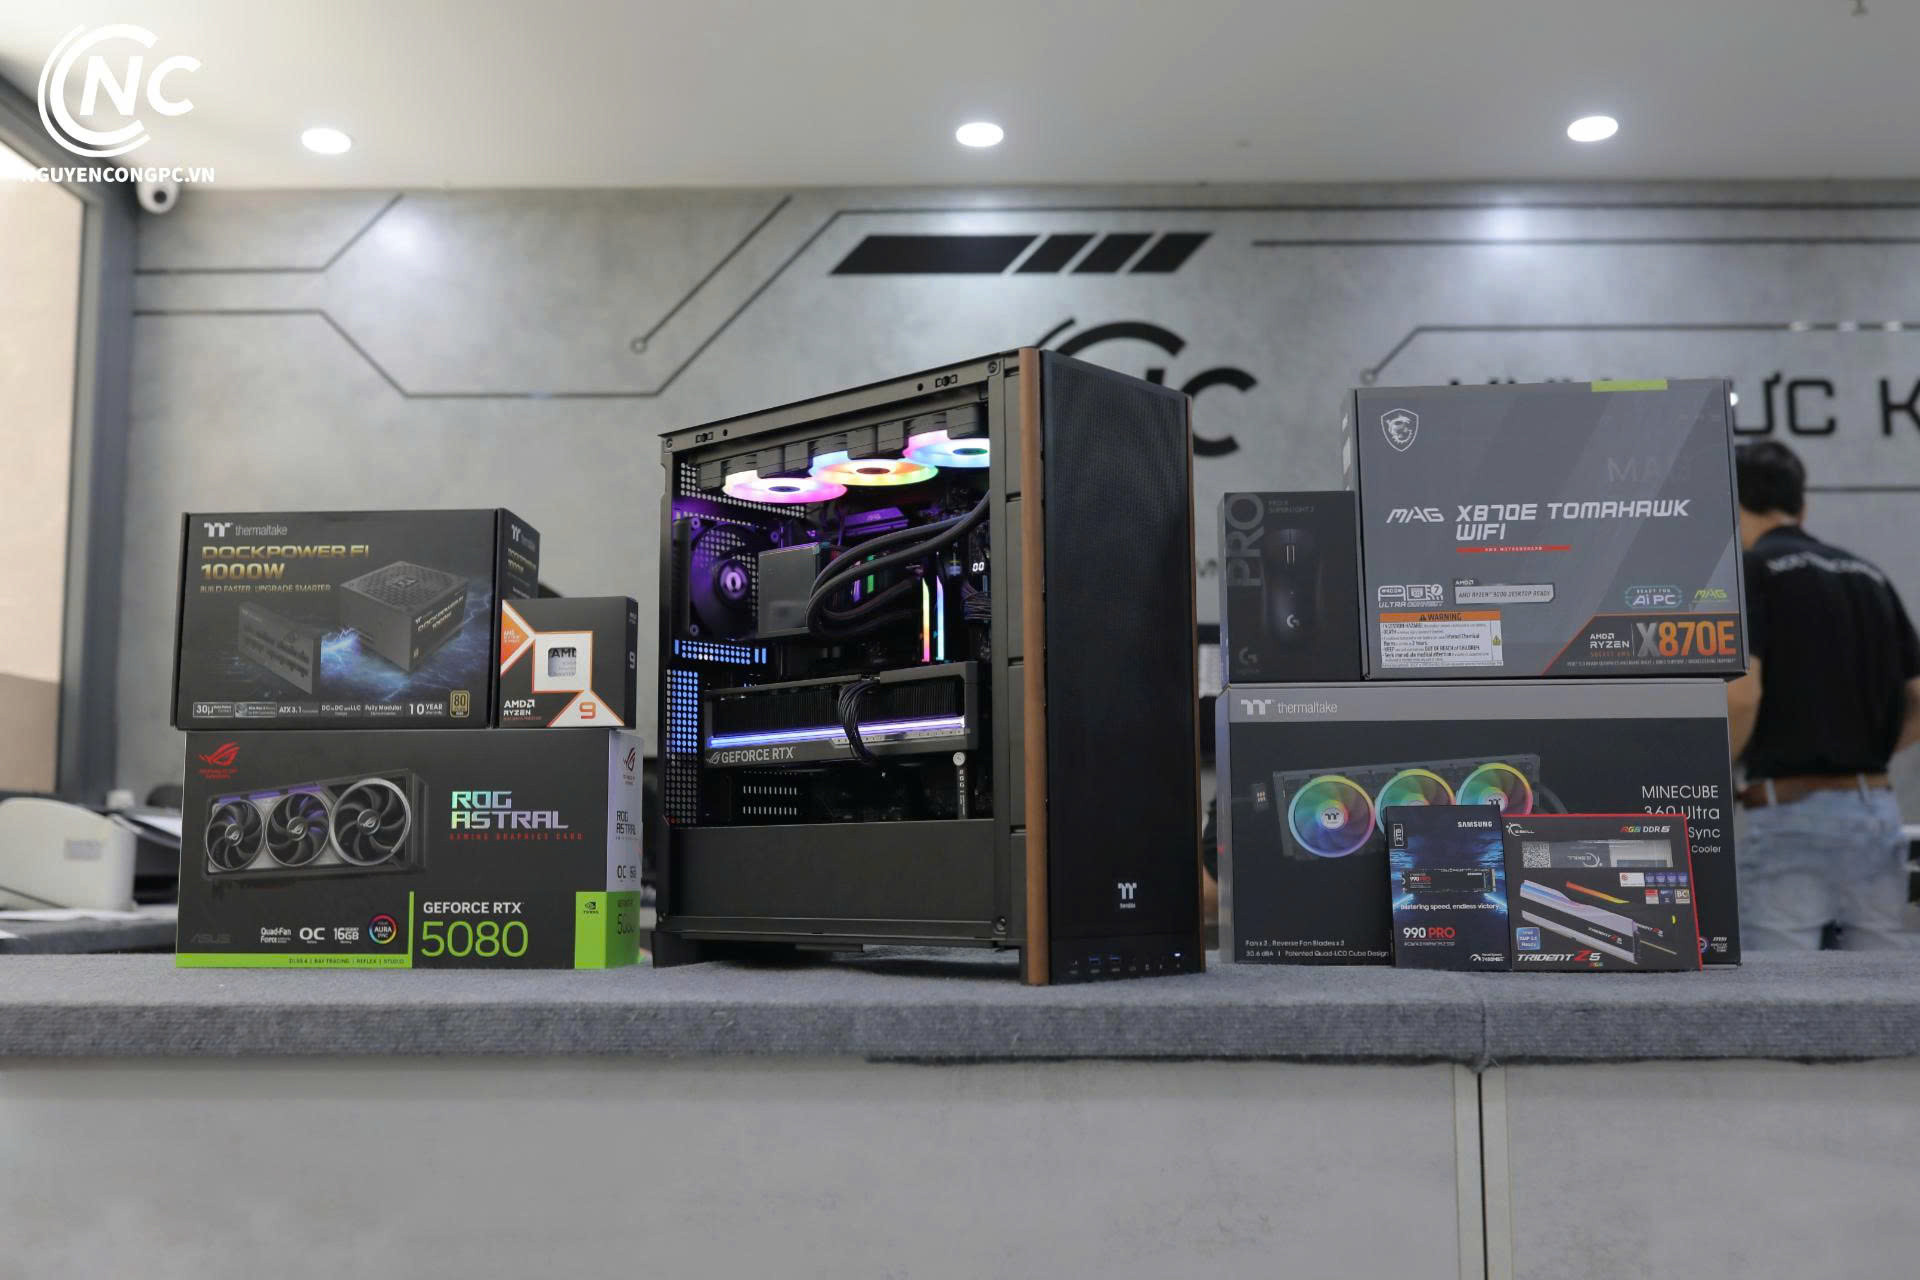
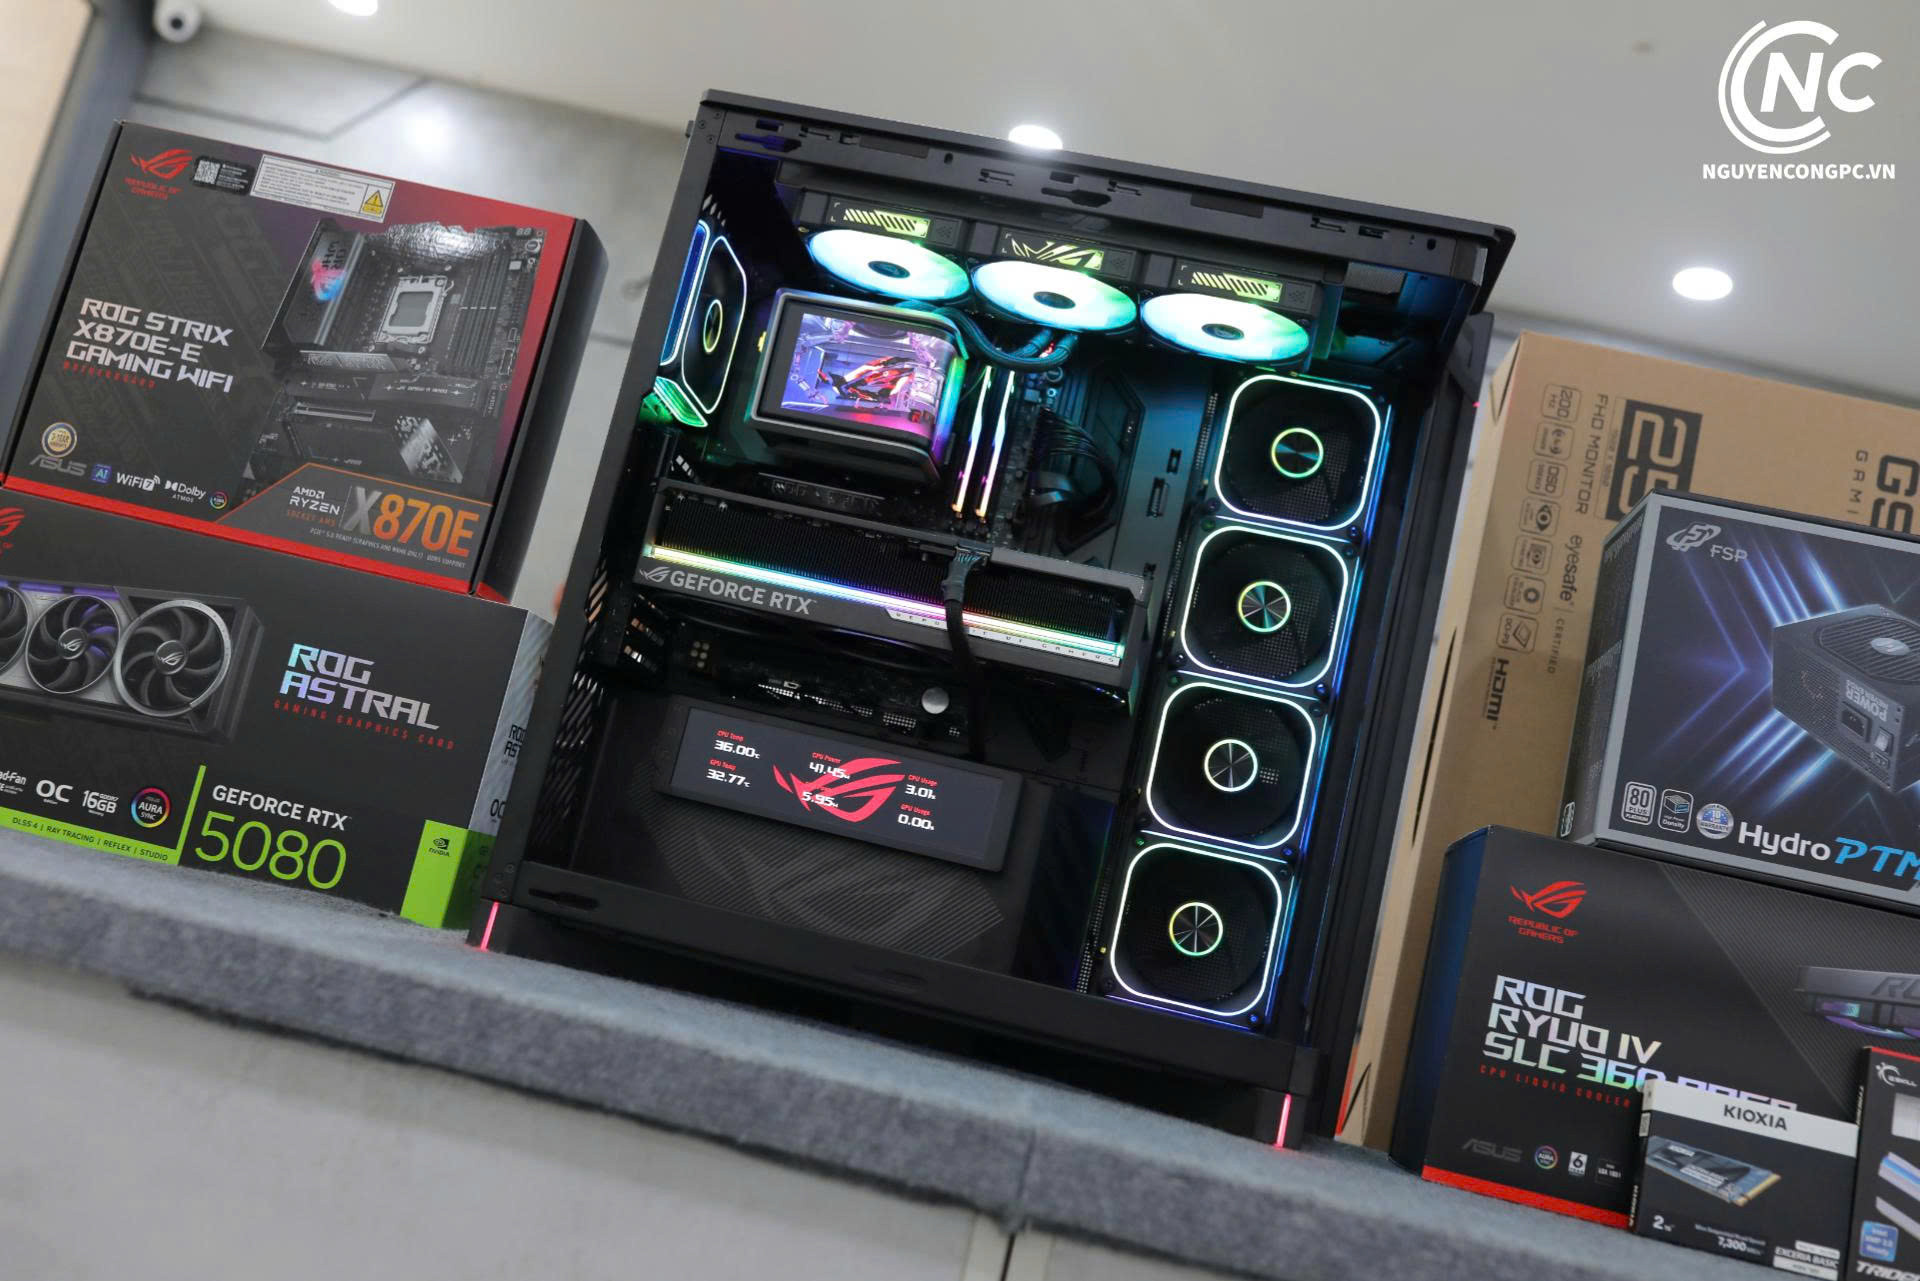
Bộ PC AI Threadripper 9960X, RTX 5080 16GB chụp tại cửa hàng, một cấu hình có thể chạy Local AI.
Local AI, Cloud AI và Hybrid AI khác nhau thế nào?
Điểm khác nhau lớn nhất là dữ liệu và việc tính toán nằm ở đâu. Bảng dưới tổng hợp sáu tiêu chí hay được đem ra so sánh nhất.
Tiêu chí
Local AI
Cloud AI
Hybrid AI
Nơi xử lý
Trên máy của bạn hoặc máy chủ nội bộ
Trên hạ tầng của nhà cung cấp, gọi qua internet
Chia việc giữa thiết bị và đám mây
Dữ liệu
Có thể giữ trên thiết bị
Gửi tới nhà cung cấp, kiểm soát theo chính sách của gói dịch vụ
Dữ liệu nhạy cảm giữ trên máy, phần còn lại có thể lên cloud
Chi phí
Nằm ở phần cứng, điện và người vận hành
Tính theo lượt dùng, không cần mua phần cứng suy luận
Cân bằng giữa hai bên
Mạng và độ trễ
Chạy được khi không có mạng, không phụ thuộc cloud đang quá tải
Cần kết nối mạng
Thiết bị xử lý mặc định, đẩy lên cloud khi cần
Mô hình
Bị giới hạn bởi bộ nhớ của máy
Dùng cho tác vụ phức tạp cần mô hình mạnh hơn hoặc thông tin trực tiếp từ internet
Chọn mô hình theo từng việc
Phần cứng
Cần GPU nhiều VRAM hoặc bộ nhớ hợp nhất lớn
Thiết bị có kết nối mạng
Cần cả hai
Nguồn: Qualcomm, The future of AI is hybrid; NVIDIA, Run AI Locally; OpenAI, Business data privacy, security, and compliance Các ô về chi phí vận hành và phần cứng cần có là nhận định của Nguyễn Công PC.
Card đồ họa GeForce RTX bên trong bộ PC AI Threadripper 9960X chụp tại cửa hàng.
Cloud AI mạnh ở đâu và cần lưu ý gì về dữ liệu?
Cloud AI cho bạn dùng mô hình lớn mà không phải mua phần cứng suy luận. Qualcomm nêu rằng ở cách chia mà thiết bị làm phần lớn việc, cloud chỉ nhận tác vụ phức tạp, như cần mô hình tốt hơn hoặc thông tin trực tiếp từ internet. Đổi lại, dữ liệu bạn nhập phải đi tới nhà cung cấp, nên điều cần đọc kỹ là chính sách xử lý dữ liệu của gói bạn dùng.
Lấy OpenAI làm ví dụ, hãng nêu rằng dữ liệu nhập vào và kết quả của ChatGPT Enterprise, Business, Edu, Healthcare, Teachers và API không được dùng để huấn luyện mô hình theo mặc định. Dữ liệu được mã hóa AES-256 khi lưu và TLS 1.2 trở lên khi truyền. Khách hàng đủ điều kiện có thể chọn lưu trữ theo khu vực, và API có tùy chọn không lưu dữ liệu. Các cam kết này áp dụng cho gói doanh nghiệp và API, nên bạn cần kiểm tra điều khoản của đúng gói mình đang dùng. Chính sách này có thể thay đổi, nên hãy đối chiếu lại trên trang của OpenAI trước khi quyết định.
Với doanh nghiệp ở Việt Nam còn có yếu tố pháp lý. Theo bản tóm tắt tháng 7/2025 của EY về Luật Bảo vệ dữ liệu cá nhân 2025 (có hiệu lực từ 1/1/2026), dùng máy chủ hoặc dịch vụ cloud ở nước ngoài để lưu trữ hay xử lý dữ liệu vẫn được tính là chuyển dữ liệu cá nhân xuyên biên giới và có hồ sơ đánh giá tác động riêng. Một số trường hợp được miễn, ví dụ doanh nghiệp lưu dữ liệu nhân viên của chính mình trên cloud nước ngoài. Mức phạt cao nhất cho vi phạm chuyển dữ liệu xuyên biên giới là 5% doanh thu năm trước hoặc 3 tỷ đồng, tùy mức nào cao hơn. Đây không phải tư vấn pháp lý, bạn nên đối chiếu văn bản chính thức hoặc hỏi luật sư trước khi quyết định.
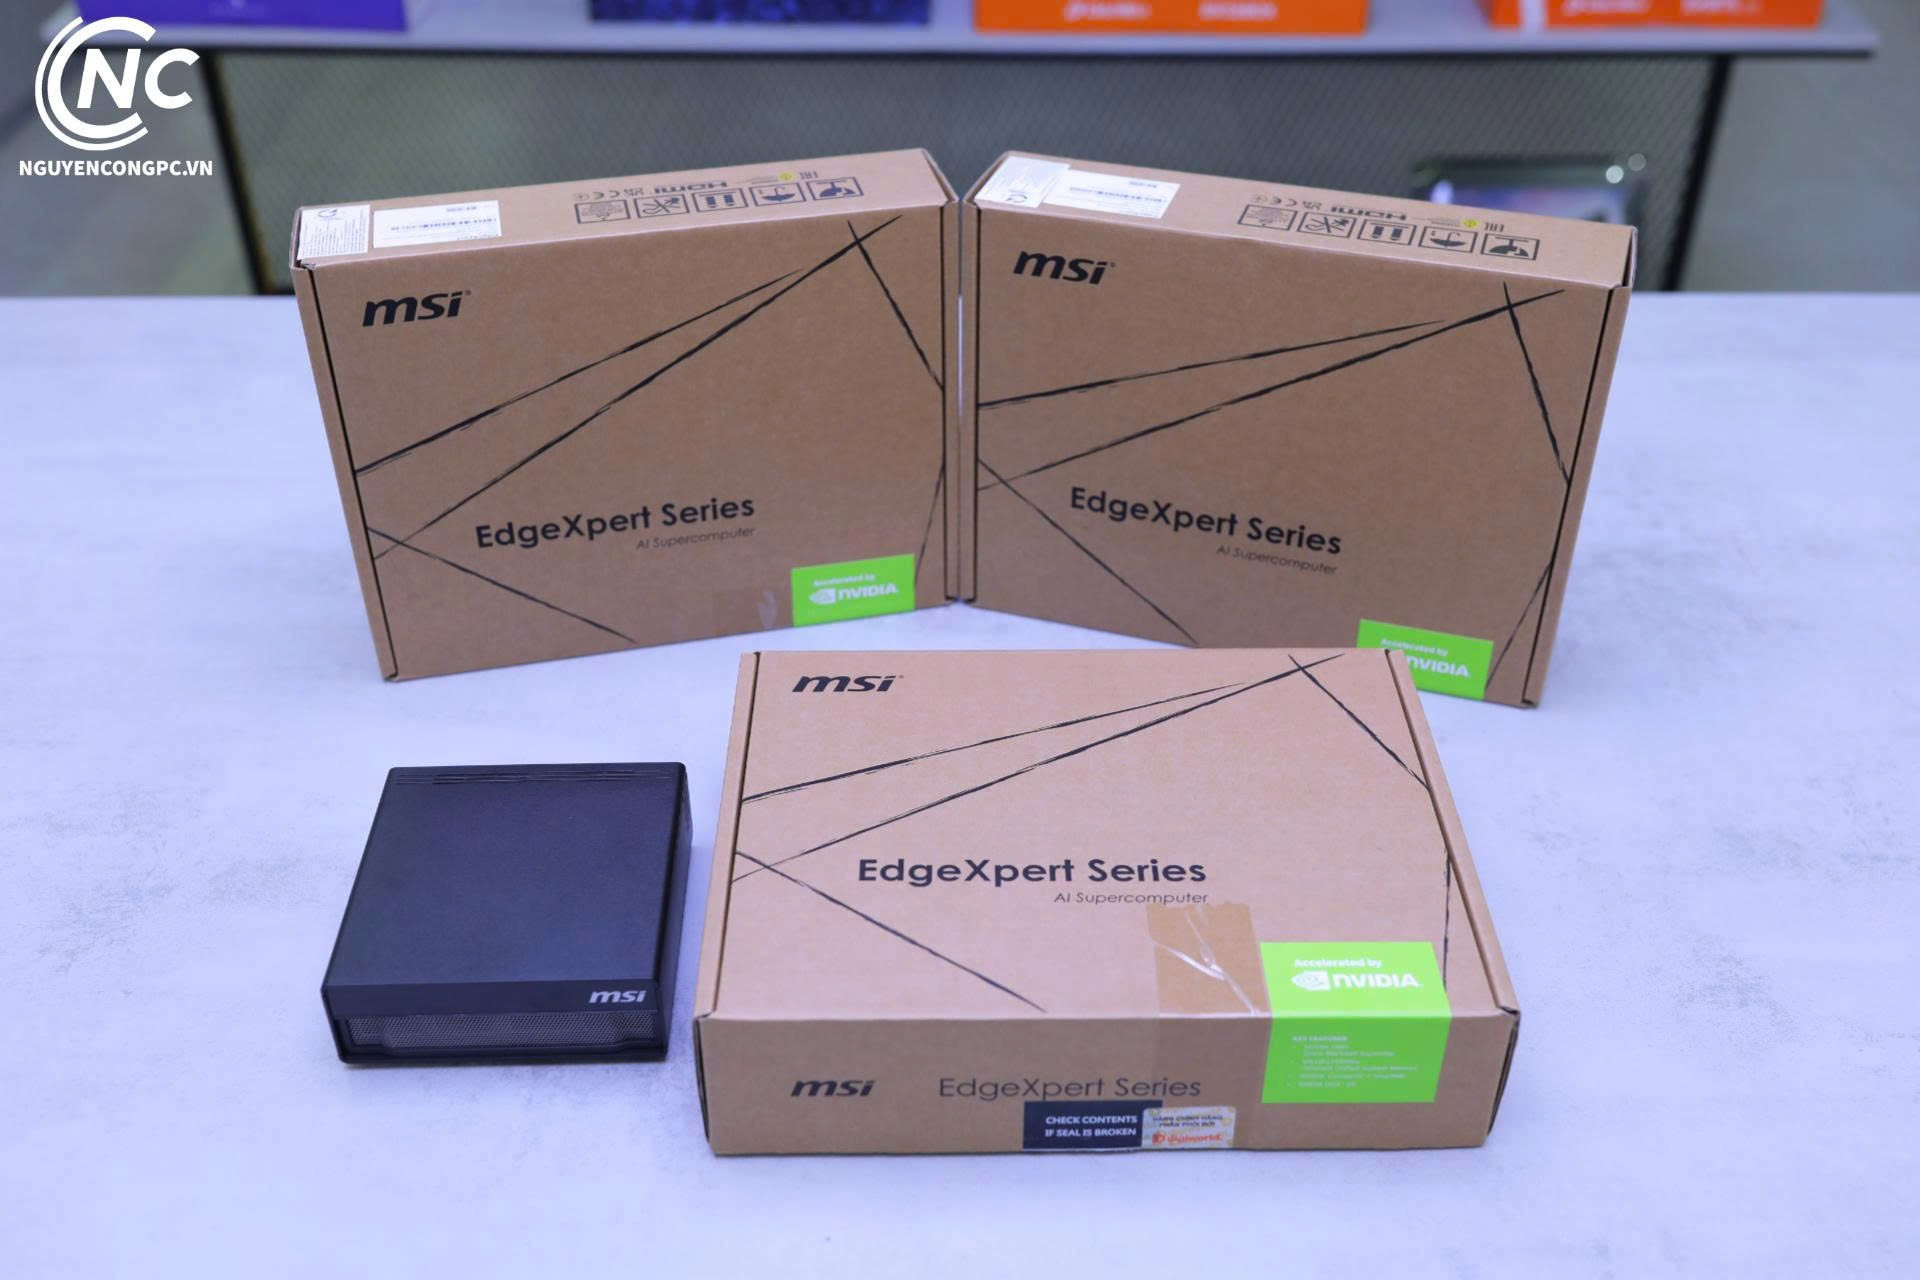
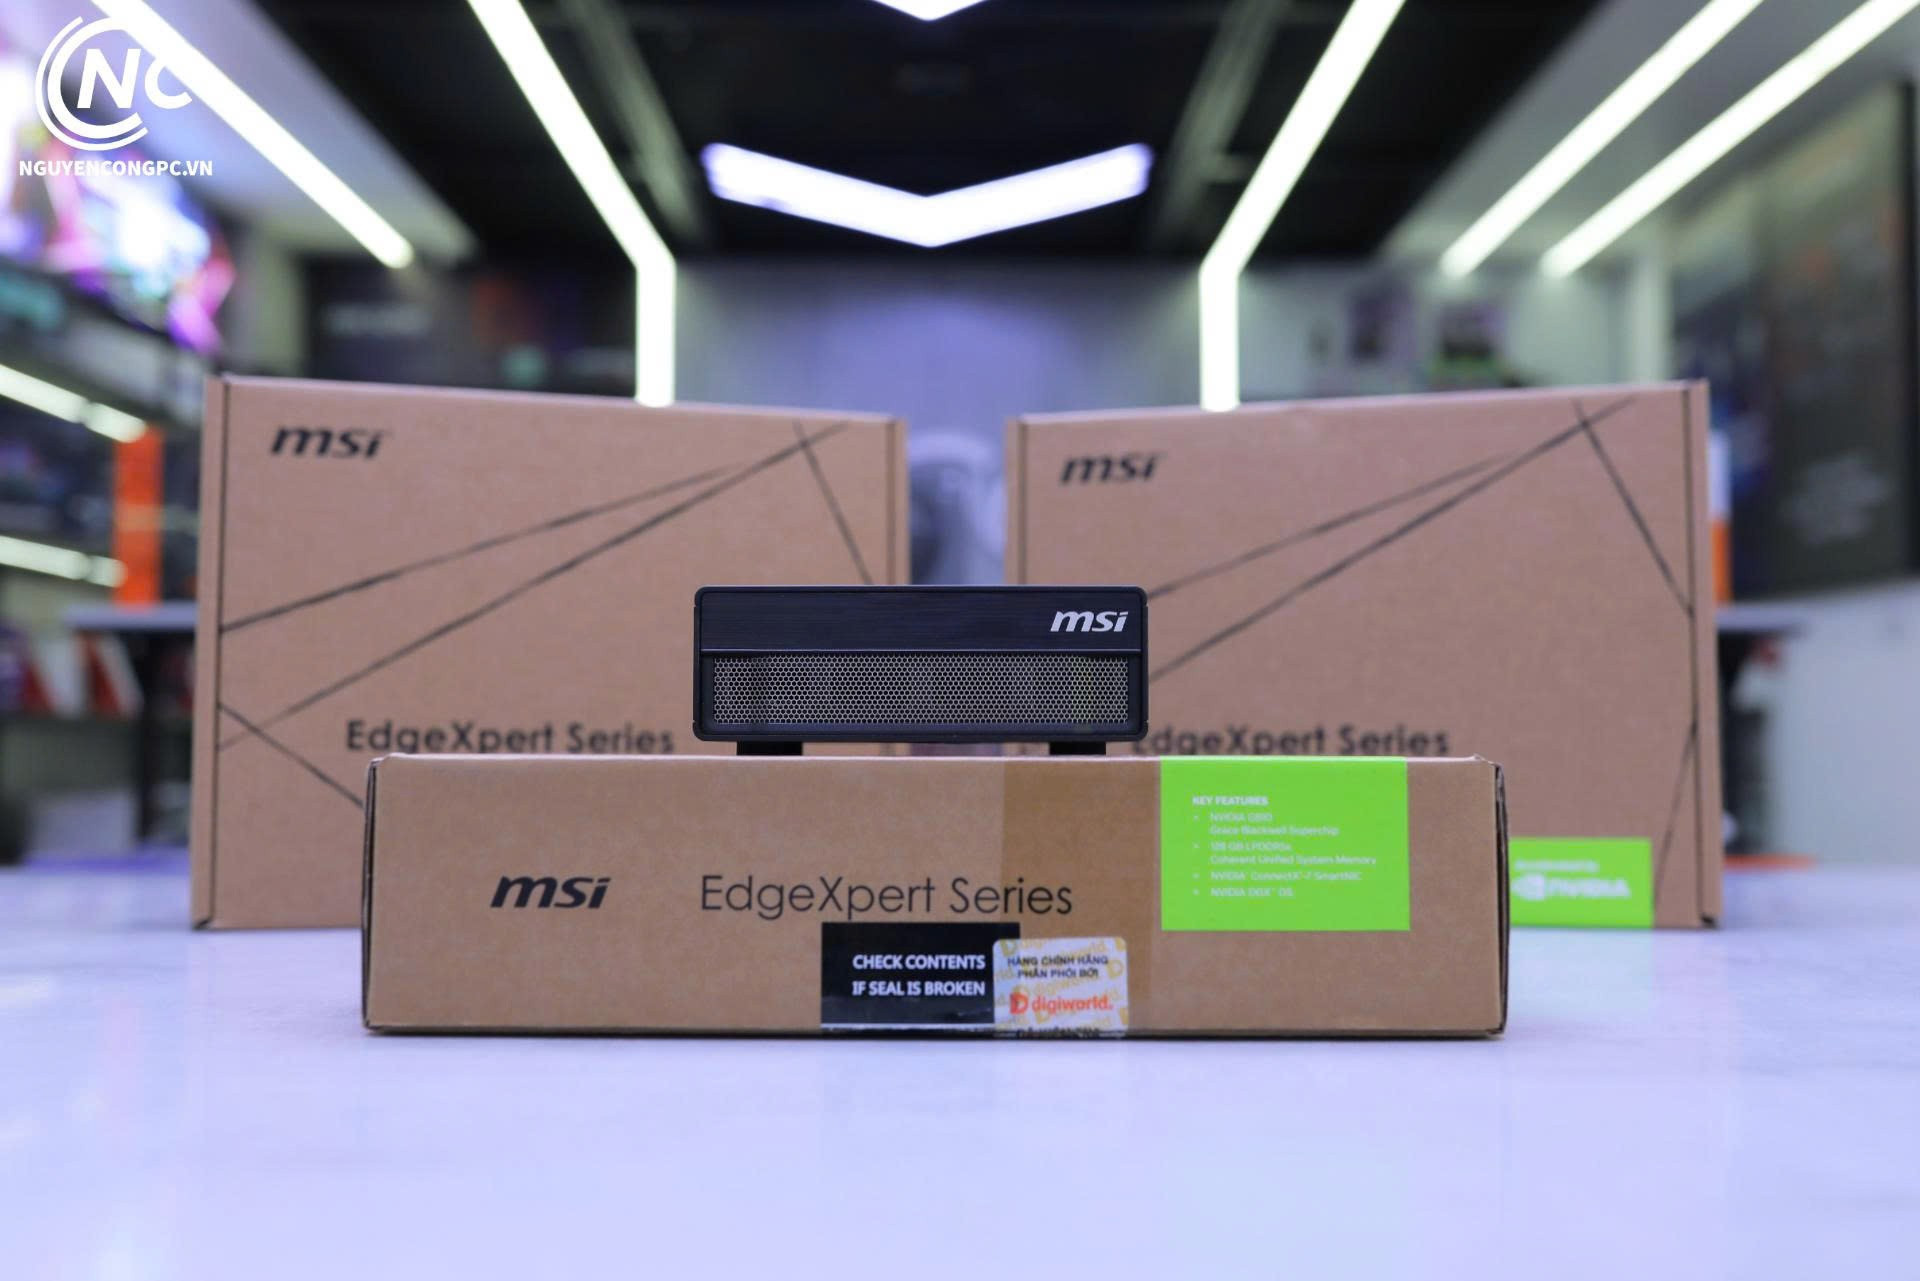
Mini PC AI MSI EdgeXpert cùng hộp, một lựa chọn chạy mô hình ngay trên máy thay vì gọi cloud.
Local AI cần phần cứng thế nào?
Local AI chạy trọn trên máy bạn nên nút thắt là bộ nhớ của GPU hoặc bộ nhớ hợp nhất. NVIDIA mô tả local AI là riêng tư, nhanh và không giới hạn lượt dùng trên GPU NVIDIA, đồng thời nêu mức bộ nhớ ứng với từng nền tảng.
Nền tảng
Bộ nhớ tối đa
Mô hình chạy được, khoảng
GeForce RTX laptop và desktop
Tới 32GB VRAM
Tới 50 tỷ tham số
RTX PRO workstation
Tới 96GB VRAM
Tới 150 tỷ tham số mỗi máy
RTX Spark (Windows)
Tới 128GB bộ nhớ hợp nhất
Tới 120 tỷ tham số
DGX Spark
Tới 128GB bộ nhớ hợp nhất
Tới 200 tỷ tham số mỗi máy
Nguồn: NVIDIA, Run AI Locally on NVIDIA
Con số của hãng có thể thay đổi theo từng thế hệ phần cứng và phần mềm, nên bạn cần kiểm tra lại trên trang của NVIDIA trước khi mua.
Trong bài về các mô hình mở của OpenAI, NVIDIA nêu cách dễ nhất để thử là dùng Ollama trên GPU từ 24GB VRAM, còn các ứng dụng như llama.cpp và Microsoft Foundry Local chạy được trên GPU từ 16GB VRAM. Hãng cho biết RTX 5090 đạt tới 256 token mỗi giây, nhưng không nêu rõ mô hình cụ thể. Nếu bạn cần mức này, các dòng card RTX 5000 và RTX 5090 tại shop là điểm bắt đầu.
Về phần mềm, Microsoft Foundry Local chạy mô hình ngay trên thiết bị, không cần dịch vụ cloud hay đăng ký Azure, nhưng lần đầu vẫn cần internet để tải mô hình. Với laptop, Microsoft yêu cầu Copilot+ PC có NPU từ 40 TOPS. Theo nhận định của Nguyễn Công PC, laptop AI hợp với các tác vụ nhẹ chạy cục bộ như ghi chú, dịch và nhận diện giọng nói.
Bộ PC AI Agent Computer Ryzen 9 9900X3D, RTX 5080 chụp tại cửa hàng.
Hybrid AI: chia việc giữa máy của bạn và đám mây
Hybrid AI không phải là dùng cả hai cho vui. Qualcomm mô tả thiết bị xử lý mặc định và chỉ đẩy lên cloud khi cần, hoặc ngược lại cloud giao bớt việc cho thiết bị khi thiết bị làm được. Có hai cách chia hay gặp. Ở cách thứ nhất, thiết bị chạy hầu hết các lần suy luận, kể cả mô hình tới hàng chục tỷ tham số, còn cloud chỉ nhận việc phức tạp. Ở cách thứ hai, thiết bị nhận diện giọng nói và đọc văn bản, còn cloud chạy mô hình ngôn ngữ lớn.
NVIDIA cũng nhắc tới thiết lập hybrid giữa local và cloud, nơi mỗi lệnh gọi mô hình được chuyển tới mô hình rẻ nhất mà vẫn làm được việc. Theo nhận định của Nguyễn Công PC, bạn có thể giữ trên máy các việc lặp lại nhiều hoặc chứa dữ liệu nhạy cảm như tóm tắt hợp đồng và tra cứu tài liệu nội bộ, rồi gọi cloud cho việc cần mô hình mạnh nhất hoặc cần thông tin mới.
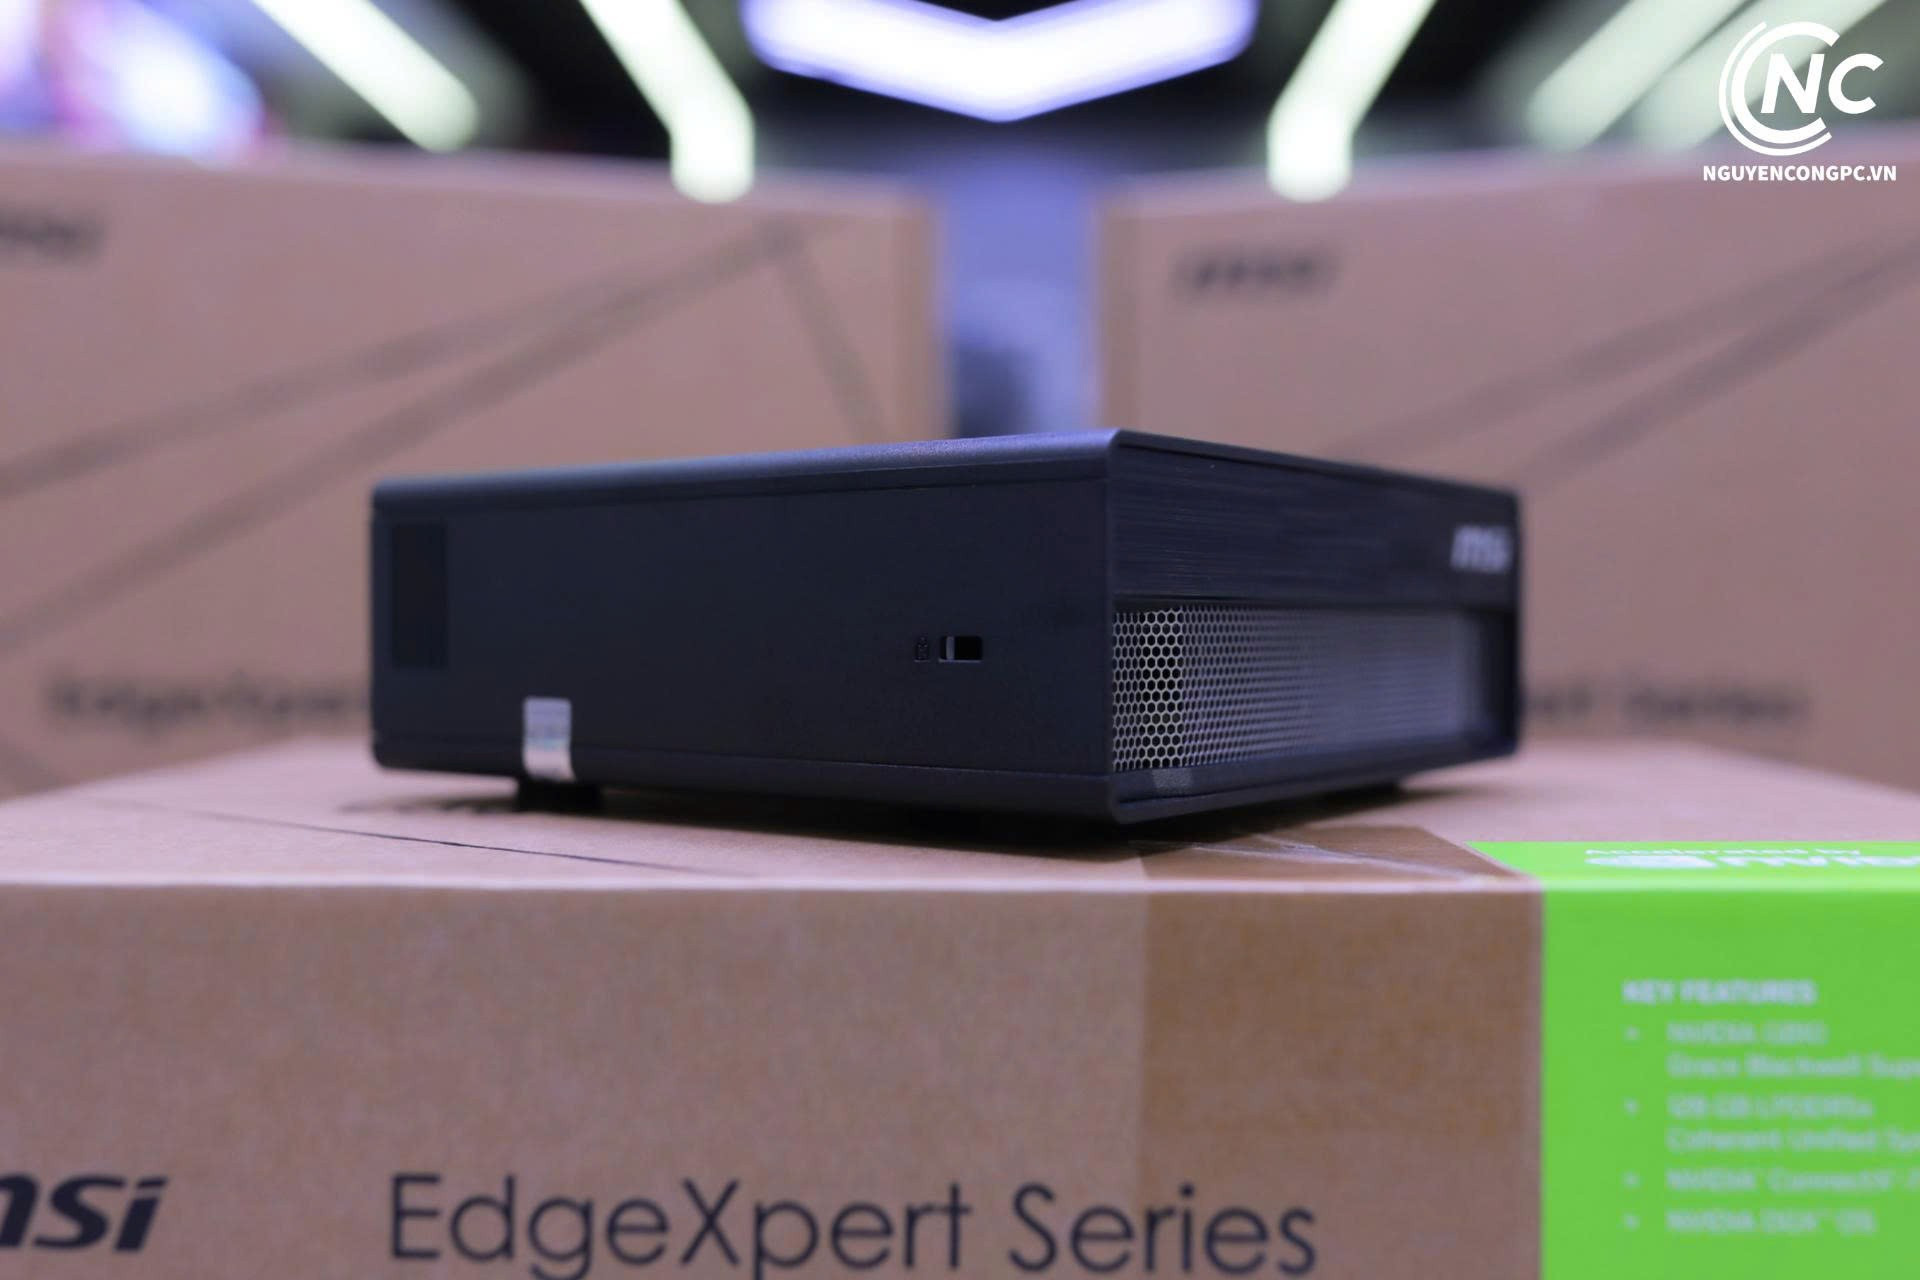
Mini PC AI MSI EdgeXpert chụp tại cửa hàng, nhỏ gọn để đặt làm máy chạy AI nội bộ.
Cá nhân và doanh nghiệp nên chọn giải pháp nào?
Bảng dưới là gợi ý theo nhận định của Nguyễn Công PC, không phải số liệu của hãng. Bạn có thể điều chỉnh theo mức nhạy cảm của dữ liệu và số lần dùng AI mỗi ngày.
Đối tượng
Nên chọn
Lý do
Thiết bị tham khảo
Cá nhân hỏi đáp, viết, dịch thỉnh thoảng
Cloud AI
Không cần mua phần cứng, dùng được ngay trên máy hiện có
Máy hiện có, hoặc laptop AI nếu muốn thử chạy cục bộ nhẹ
Freelancer, dev, người làm nội dung dùng AI hằng ngày
Hybrid AI
Việc lặp lại chạy trên máy, việc cần mô hình lớn gọi cloud
PC Agent Computer RTX 5080 16GB
Cá nhân hoặc nhóm nhỏ xử lý dữ liệu khách hàng, hợp đồng, mã nguồn nội bộ
Local AI
Dữ liệu ở lại trên máy của bạn
PC AI hoặc mini PC AI 128GB bộ nhớ hợp nhất
Doanh nghiệp vừa, nhiều phòng ban dùng AI
Hybrid AI
Chia theo mức nhạy cảm của dữ liệu và độ phức tạp của việc
PC AI nhiều GPU, mini PC AI làm máy suy luận nội bộ
Doanh nghiệp có dữ liệu cá nhân hoặc dữ liệu bị quản lý chặt
Local AI, hoặc Hybrid AI có kiểm soát
Giữ dữ liệu nhạy cảm trong nhà, chỉ đưa dữ liệu đã được duyệt lên cloud
Workstation Threadripper nhiều khe RAM
Nguồn: Nhận định của Nguyễn Công PC, dựa trên các nguồn của Qualcomm, NVIDIA, OpenAI và EY nêu ở các mục trên, không phải số liệu công bố của hãng.
Hai card MSI GeForce RTX 5090 32GB trong bộ PC AI Ryzen 9 9950X.
Doanh nghiệp nên tự hỏi ba câu trước khi chọn
Ba câu hỏi dưới đây giúp doanh nghiệp quyết định nhanh hơn việc chạy gì ở đâu.
Dữ liệu nào không được rời khỏi hệ thống? Dữ liệu cá nhân, hợp đồng, mã nguồn và số liệu tài chính nên được phân loại trước. Phần nhạy cảm giữ local, phần còn lại có thể dùng cloud.
Mức dùng mỗi ngày là bao nhiêu? Qualcomm cho rằng suy luận AI tạo sinh trên cloud tốn kém và chạy trên thiết bị giúp giảm chi phí mỗi lượt. Nếu cả đội dùng AI liên tục, hãy so tổng chi phí cloud với chi phí phần cứng trước khi quyết.
Ai vận hành? Local AI cần người cài đặt, cập nhật mô hình và bảo trì máy. Nếu doanh nghiệp chưa có người làm việc đó, Hybrid với phần local nhỏ là điểm bắt đầu dễ hơn.
Bộ máy gợi ý để chạy Local AI và Hybrid AI
Dưới đây là năm bộ đang bán tại Nguyễn Công PC, dùng làm máy chạy Local AI hoặc phần local của Hybrid AI. Thông số lấy từ bảng thông số sản phẩm trên web. Bạn có thể xem thêm các mẫu khác ở danh mục Agent Computer.
Bộ PC AI Agent Computer Ryzen 9 9900X3D, RAM 64GB, RTX 5080 đặt tại cửa hàng.
Đây là mức vào cửa cho Local AI trong các bộ gợi ý, theo nhận định của Nguyễn Công PC hợp cá nhân và freelancer muốn chạy mô hình ngay trên máy với dữ liệu riêng. RTX 5080 16GB đạt mức tối thiểu 16GB VRAM mà NVIDIA nêu cho llama.cpp và Microsoft Foundry Local. CPU 12 nhân, RAM 64GB và SSD 2TB đủ cho phần xử lý dữ liệu đi kèm, còn HDD 4TB dùng để cất dữ liệu và các mô hình đã tải về.
Nguồn: FSP Hydro PTM X PRO 1200W 80 Plus Platinum (ATX 3.0, PCIe 5.0)
Case: ASUS ROG CRONOX GR801 CURVE TG SCREEN Black (không kèm quạt)
Tản nhiệt: Tản nhiệt nước ASUS ROG Ryuo IV SLC 360 ARGB
Fan: 4 x Fan LED DTV DT-V2 Pro đen ngược + 1 x Fan LED DTV DT-V2 Pro đen xuôi
Phụ kiện: Màn hình phụ TURZX 8.8 inch Black (hiển thị thông số PC, tấm nền IPS); giá treo màn hình VSP VA80-1G (17-32 inch, chân đơn, màu đen xám)
Bộ PC AI Agent Computer Ryzen 9 9950X3D, RAM 64GB, RTX 5080 chụp tại cửa hàng.
Bộ này hợp với cá nhân và nhóm nhỏ chạy mô hình ngay trên máy. RTX 5080 16GB đạt mức tối thiểu 16GB VRAM mà NVIDIA nêu cho llama.cpp và Foundry Local, còn Ollama theo NVIDIA cần từ 24GB nên bộ này chưa đạt mức đó. CPU 16 nhân, RAM 64GB và SSD 2TB giúp phần còn lại của quy trình, như xử lý dữ liệu đầu vào hay chạy cơ sở dữ liệu cục bộ, không làm chậm mô hình. Bộ không kèm HDD nên nếu cần lưu nhiều dữ liệu thô bạn cần thêm ổ cứng.
[Products:30534]
PC AI Threadripper 9960X, RTX 5080 16GB, mainboard 8 khe RAM
Bộ PC AI Threadripper 9960X, RTX 5080 16GB đặt tại cửa hàng.
Bộ này nhắm tới doanh nghiệp cần mở rộng RAM về sau, theo nhận định của Nguyễn Công PC hợp làm máy AI nội bộ cho một phòng ban. Mainboard TRX50 có 8 khe RAM DDR5 và đang dùng 2 thanh Kingston 32GB ECC, tổng 64GB, nên còn khe trống để nâng dần dung lượng. RTX 5080 16GB đạt mức tối thiểu 16GB VRAM mà NVIDIA nêu cho llama.cpp và Foundry Local, CPU 24 nhân 48 luồng giúp các tác vụ chạy song song như xử lý tài liệu, còn HDD 8TB đủ chỗ lưu tài liệu nội bộ.
[Products:16309]
PC AI Ryzen 9 9950X, RAM 128GB, Dual RTX 5090 32GB
RAM: 2 bộ Kingston Fury Beast Black RGB 64GB (2x32GB) DDR5 6000MHz, tổng 128GB
SSD: Samsung 990 PRO 2TB
Mainboard: ASUS ROG Crosshair X870E Glacial
Nguồn: Super Flower Leadex Platinum 2000W 80 Plus Platinum (SF-2000F14HP)
Case: ASUS ROG Hyperion GR701 White
Tản nhiệt: Tản nhiệt nước ASUS ROG Ryuo IV SLC 360 ARGB
Bộ PC AI Ryzen 9 9950X, RAM 128GB, hai card RTX 5090 32GB chụp tại cửa hàng.
Mỗi card RTX 5090 có 32GB VRAM, vượt mức 24GB mà NVIDIA nêu cho Ollama, và hai card cho tổng 64GB VRAM. Việc một mô hình dùng chung VRAM của hai card hay không phụ thuộc phần mềm bạn chọn, nên bạn nên kiểm tra trước khi mua. RAM 128GB đi cùng nguồn 2000W Platinum, theo nhận định của Nguyễn Công PC hợp doanh nghiệp muốn một máy suy luận nội bộ mạnh cho cả nhóm dùng chung. Đây là cấu hình lớn nên bạn nên tính cả chỗ đặt và chi phí điện.
[Products:29264]
Mini PC AI MSI EdgeXpert-55SVN, 128GB bộ nhớ hợp nhất
Cấu hình chi tiết:
CPU: NVIDIA Grace Blackwell GB10, ARM 20 nhân (10 x Cortex-X925 + 10 x Cortex-A725)
GPU: NVIDIA GB10 (kiến trúc Blackwell)
Hiệu năng AI: 1 PetaFLOP (FP4 Sparse), khoảng 1000 AI TOPS
RAM: 128GB LPDDR5x Unified Memory dùng chung cho CPU và GPU (hàn chết, không nâng cấp)
Ổ cứng: 4TB M.2 NVMe SSD
Mạng: 1 x 10GbE, NVIDIA ConnectX-7 Smart NIC 200Gbps, Wi-Fi 7
Hệ điều hành: NVIDIA DGX OS
Kích thước: 151 x 151 x 52 mm, nặng 1.2kg
Bảo hành: 36 tháng
Mini PC AI MSI EdgeXpert-55SVN cùng hộp sản phẩm chụp tại cửa hàng.
Máy có 128GB bộ nhớ hợp nhất dùng chung cho CPU và GPU, nên dung lượng dành cho mô hình lớn hơn nhiều so với card đồ họa rời 16GB. Theo bảng của NVIDIA ở trên, các nền tảng 128GB bộ nhớ hợp nhất ứng với mô hình tới khoảng 120 đến 200 tỷ tham số, còn con số thực tế của mẫu này phụ thuộc phần mềm và cách lượng tử hóa mô hình. Máy chạy NVIDIA DGX OS trên nền ARM nên bạn cần kiểm tra phần mềm đang dùng có chạy được trước khi mua, và RAM hàn chết nên không nâng cấp được. Nếu muốn một mẫu khác cùng nền tảng NVIDIA GB10, shop còn có Mini PC AI ASUS Ascent GX10 với 128GB bộ nhớ và SSD 1TB.
[Products:29769]
Ba sai lầm hay gặp khi chọn Local AI, Cloud AI hay Hybrid AI
Nghĩ chạy local luôn rẻ hơn cloud. Local chuyển chi phí sang phần cứng, điện và người vận hành. Bạn nên so tổng chi phí theo mức dùng thực tế trước khi mua.
Đưa dữ liệu nhạy cảm lên cloud khi chưa đọc chính sách của gói đang dùng. Cam kết không dùng dữ liệu để huấn luyện mà OpenAI nêu áp dụng cho gói doanh nghiệp và API, bạn cần kiểm tra điều khoản của đúng gói mình dùng.
Mua phần cứng thiếu bộ nhớ cho mô hình cần chạy. NVIDIA nêu Ollama cần từ 24GB VRAM và llama.cpp từ 16GB VRAM, nên card 8GB hay 12GB không đủ cho các mô hình cỡ đó.
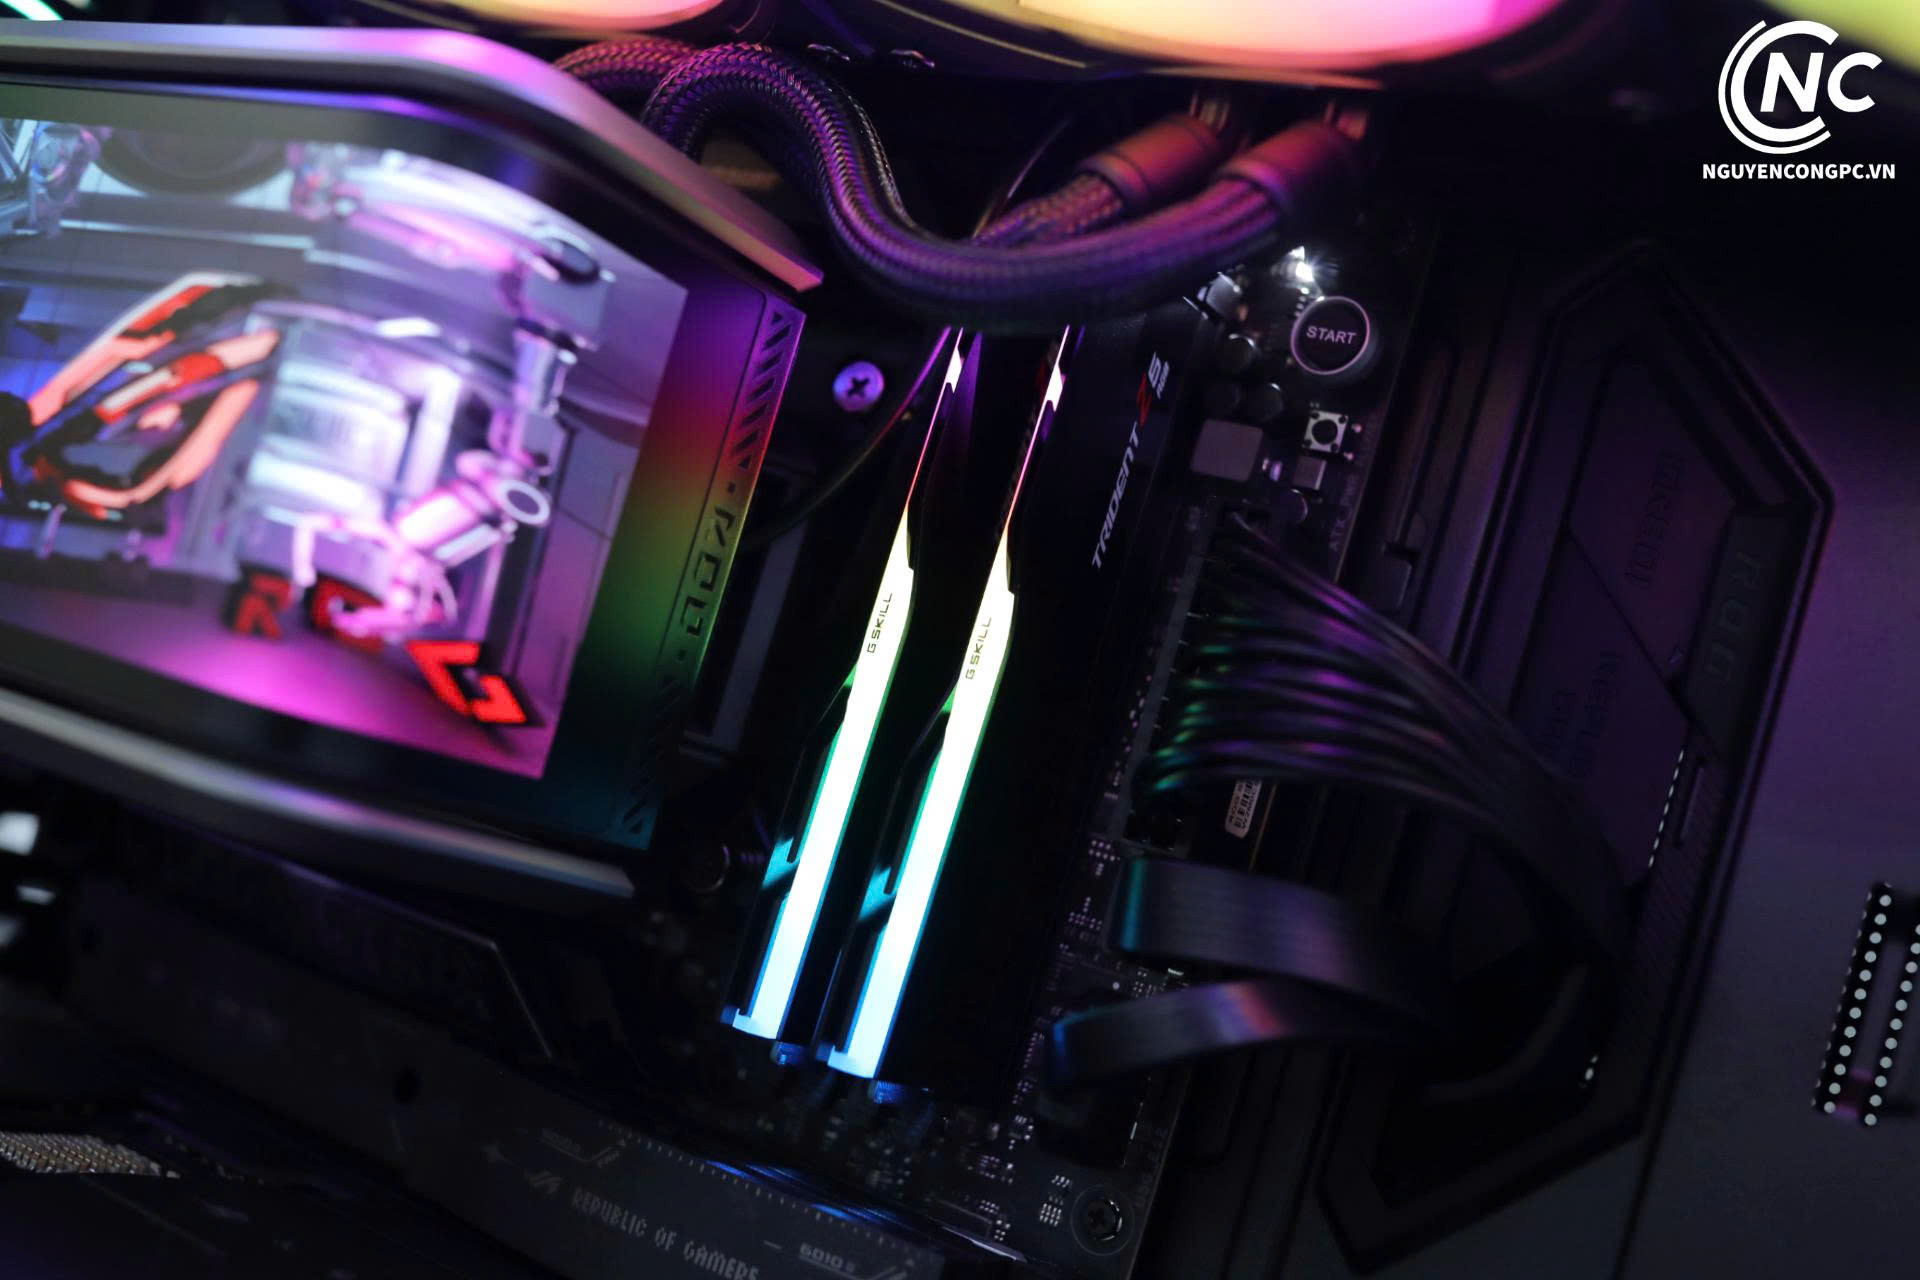
RAM G.Skill Trident Z5 RGB 64GB (2x32GB) trong bộ PC AI Agent Computer 9950X3D.
Câu hỏi thường gặp
Local AI có riêng tư tuyệt đối không?
Local AI giữ dữ liệu trên thiết bị của bạn, đó là điểm NVIDIA và Qualcomm đều nhấn mạnh. Tuy vậy mức riêng tư còn phụ thuộc cách bạn bảo mật chính chiếc máy đó, và lần đầu bạn vẫn cần internet để tải mô hình, như Microsoft ghi cho Foundry Local. Vì vậy hãy coi local là cách giảm rủi ro dữ liệu rời hệ thống, không phải bảo đảm tuyệt đối.
Cloud AI có dùng dữ liệu của tôi để huấn luyện mô hình không?
Còn tùy nhà cung cấp và gói dịch vụ. OpenAI nêu rằng dữ liệu của ChatGPT Enterprise, Business, Edu, Healthcare, Teachers và API không được dùng để huấn luyện theo mặc định, và khách hàng API có thể chủ động bật chia sẻ qua bảng điều khiển API. Với nhà cung cấp khác hoặc gói khác, bạn cần đọc điều khoản dữ liệu của đúng gói đang dùng.
Hybrid AI là gì và khi nào nên dùng?
Hybrid AI là cách chia việc giữa thiết bị và đám mây, theo Qualcomm là đặt mỗi phép tính ở nơi chạy tốt nhất. Theo nhận định của Nguyễn Công PC, bạn nên dùng khi vừa có dữ liệu nhạy cảm cần giữ trong nhà, vừa có việc cần mô hình lớn hơn khả năng của máy mình.
Chạy Local AI cần card đồ họa bao nhiêu VRAM?
Còn tùy kích thước mô hình. NVIDIA nêu GeForce RTX tới 32GB VRAM chạy được mô hình tới khoảng 50 tỷ tham số, còn nền tảng 128GB bộ nhớ hợp nhất ứng với khoảng 120 đến 200 tỷ tham số. Với các mô hình mở của OpenAI, NVIDIA nêu mức tối thiểu 16GB VRAM với llama.cpp và Foundry Local, 24GB với Ollama.
Doanh nghiệp nhỏ nên bắt đầu từ Local, Cloud hay Hybrid?
Theo nhận định của Nguyễn Công PC, bạn có thể bắt đầu bằng Cloud AI cho các việc không nhạy cảm, rồi thêm một máy chạy local cho phần dữ liệu cần giữ trong nhà. Cách này thành Hybrid AI mà không phải đầu tư lớn ngay từ đầu.
Kết luận
Không có lựa chọn đúng cho mọi người. Cloud AI hợp với việc dùng nhẹ, Local AI hợp với dữ liệu nhạy cảm hoặc nhu cầu dùng liên tục, còn Hybrid AI là điểm cân bằng cho phần lớn doanh nghiệp. Khi đã biết mình cần chạy mô hình cỡ nào, bạn có thể xem các bộ PC chạy AI tại Nguyễn Công PC để chọn cấu hình có đủ VRAM và bộ nhớ.
RTX 5090 32GB hợp với model AI lượng tử hóa đến khoảng 30 tỷ tham số, còn RTX PRO 6000 Blackwell 96GB ECC chạy được model 70 đến 120 tỷ tham số trên một card. So sánh thông số, tốc độ AI, tính năng chuyên nghiệp và gợi ý bộ PC AI.
Dựng video 4K cần CPU từ 8 nhân, RAM tối thiểu 32GB, card đồ họa từ 8GB VRAM và ổ NVMe riêng cho cache. Cách chọn CPU Intel Quick Sync hay AMD, card RTX 50, dung lượng RAM và ổ cứng theo khuyến nghị Adobe, Blackmagic, Puget Systems.
RX 9070 XT tương đương RTX 5070 Ti khi chơi game không bật ray tracing, nhưng tụt về gần RTX 5070 khi bật ray tracing nặng. So sánh thông số, FPS, DLSS và FSR, điện năng và gợi ý nên chọn card nào.
Laptop cũ giúp tiết kiệm chi phí nhưng dễ gặp pin chai, SSD hao mòn, không lên được Windows 11 hoặc bị khóa doanh nghiệp. Checklist 11 bước kiểm tra laptop cũ trước khi mua.
RTX 5090 đạt bao nhiêu FPS ở 1440p và 4K, nhanh hơn RTX 4090, RTX 5080 bao nhiêu, khi bật ray tracing, DLSS 4 và Multi Frame Generation ra sao, cần nguồn bao nhiêu W, kèm các bộ PC RTX 5090 tại Nguyễn Công PC.
RTX 5080 đạt bao nhiêu FPS ở 1440p và 4K, nhanh hơn RTX 4080 Super, RTX 5070 Ti bao nhiêu, khi bật ray tracing, DLSS 4 và Multi Frame Generation ra sao, kèm các bộ PC RTX 5080 tại Nguyễn Công PC.
Mini PC AI GB10 dùng cho chạy mô hình lớn tại chỗ, tinh chỉnh mô hình, dựng ứng dụng AI và xử lý dữ liệu nội bộ. Bài nêu việc máy làm tốt và việc máy không hợp.
So sánh ba mini PC AI dùng chip GB10: MSI EdgeXpert MS-C931, Gigabyte AI TOP ATOM ATAGB10-9000 và ASUS Ascent GX10 theo SSD, cổng kết nối, cân nặng và nhu cầu sử dụng.
DGX Spark là máy tính AI để bàn của NVIDIA dùng chip GB10 với 128 GB bộ nhớ dùng chung. Bài giải thích chip, thông số, việc máy làm được và ai nên mua.
Mini PC AI GB10 hợp với ai và không hợp với ai? Bài này đi qua 128 GB bộ nhớ, băng thông 273 GB/s, chip Arm, Linux và cách chọn giữa MSI EdgeXpert, Gigabyte AI TOP ATOM, ASUS Ascent GX10.












 PC GAMING
 LAPTOP
 LINH KIỆN MÁY TÍNH
 MÀN HÌNH MÁY TÍNH