Build PC chạy AI local: cần bao nhiêu CPU, RAM, VRAM theo từng cỡ model?
Hoài Anh06-11-2026, 9:09 am
Muốn build PC chạy AI local, bạn cần tính VRAM trước, rồi mới đến RAM và CPU. Với lượng tử hóa Q4_K_M, trọng số của model 8B chiếm khoảng 4,6GiB, 14B khoảng 8GiB, 32B khoảng 18GiB và 70B khoảng 40GiB. Cộng thêm KV cache theo độ dài ngữ cảnh và phần dự phòng, mức VRAM nên có lần lượt là khoảng 8GB, 12GB, 24GB và 48GB. RAM hệ thống chỉ đóng vai trò cứu hộ khi model tràn VRAM và tốc độ sẽ giảm rõ, còn CPU ít quyết định tốc độ hơn nhiều người nghĩ. Bài này đưa công thức ước tính, bảng số có nguồn và 10 cấu hình theo 5 tầng ngân sách để bạn chọn đúng cỡ model mình cần chạy.
Bộ nhớ khi chạy model gồm những phần nào?
Khi chạy một model ngôn ngữ trên máy, bộ nhớ được chia thành ba phần. Phần đầu là trọng số, tức file model được nạp vào VRAM, kích thước phụ thuộc số tham số và mức lượng tử hóa. Phần thứ hai là KV cache, nơi lưu ngữ cảnh của cuộc trò chuyện và tăng dần theo độ dài ngữ cảnh. Phần thứ ba là phần dự phòng cho phần mềm chạy model và hệ điều hành. Nhiều người chỉ nhìn phần đầu nên chọn card vừa khít, rồi gặp lỗi hết bộ nhớ khi mở ngữ cảnh dài.
Lượng tử hóa là cách nén trọng số xuống ít bit hơn để model nhỏ đi. Theo tài liệu llama.cpp, một model 8B nặng khoảng 15GiB ở dạng F16 nhưng chỉ còn khoảng 4,6GiB ở Q4_K_M. Đổi lại, model bị nén nên chất lượng có thể giảm, mức giảm tùy model và tác vụ, vì vậy bạn nên thử với đúng công việc của mình trước khi chốt.
Mức lượng tử hóa
Bit mỗi trọng số
Dung lượng model 8B (GiB)
Q4_K_M
4,89
4,58
Q5_K_M
5,70
5,33
Q8_0
8,50
7,95
F16
16,00
14,96
Nguồn: tài liệu llama.cpp (bảng lượng tử hóa, kích thước F16 14,96GiB tương ứng model 8B).
Bảng VRAM theo cỡ model: 8B, 14B, 32B, 70B
Từ mức 4,89 bit mỗi trọng số của Q4_K_M, dung lượng trọng số xấp xỉ bằng số tỷ tham số nhân với 0,57GiB. Cách tính này cho kết quả gần đúng, vì mỗi model có tỷ lệ bit khác nhau một chút. Bài dùng GiB cho dung lượng model và KV cache (1GiB bằng khoảng 1,07GB) và dùng GB cho dung lượng VRAM ghi trên card. Cột gợi ý VRAM trong bảng là nhận định của Nguyễn Công PC, đã cộng KV cache ở ngữ cảnh vừa phải và phần dự phòng.
Cỡ model
Trọng số Q4_K_M (GiB, ước tính)
VRAM tối thiểu nên có
VRAM thoải mái
8B
4,6
8GB
12GB
14B
8,0
12GB
16GB
32B
18,2
24GB
32GB
70B
39,9
48GB
64GB
gpt-oss-20b (MoE, 21B tổng)
Theo OpenAI cần 16GB
16GB
24GB
gpt-oss-120b (MoE, 117B tổng)
Theo OpenAI chạy trong 80GB
80GB
96GB
Nguồn: tài liệu llama.cpp (bit mỗi trọng số), OpenAI (gpt-oss). Hai cột VRAM là nhận định của Nguyễn Công PC.
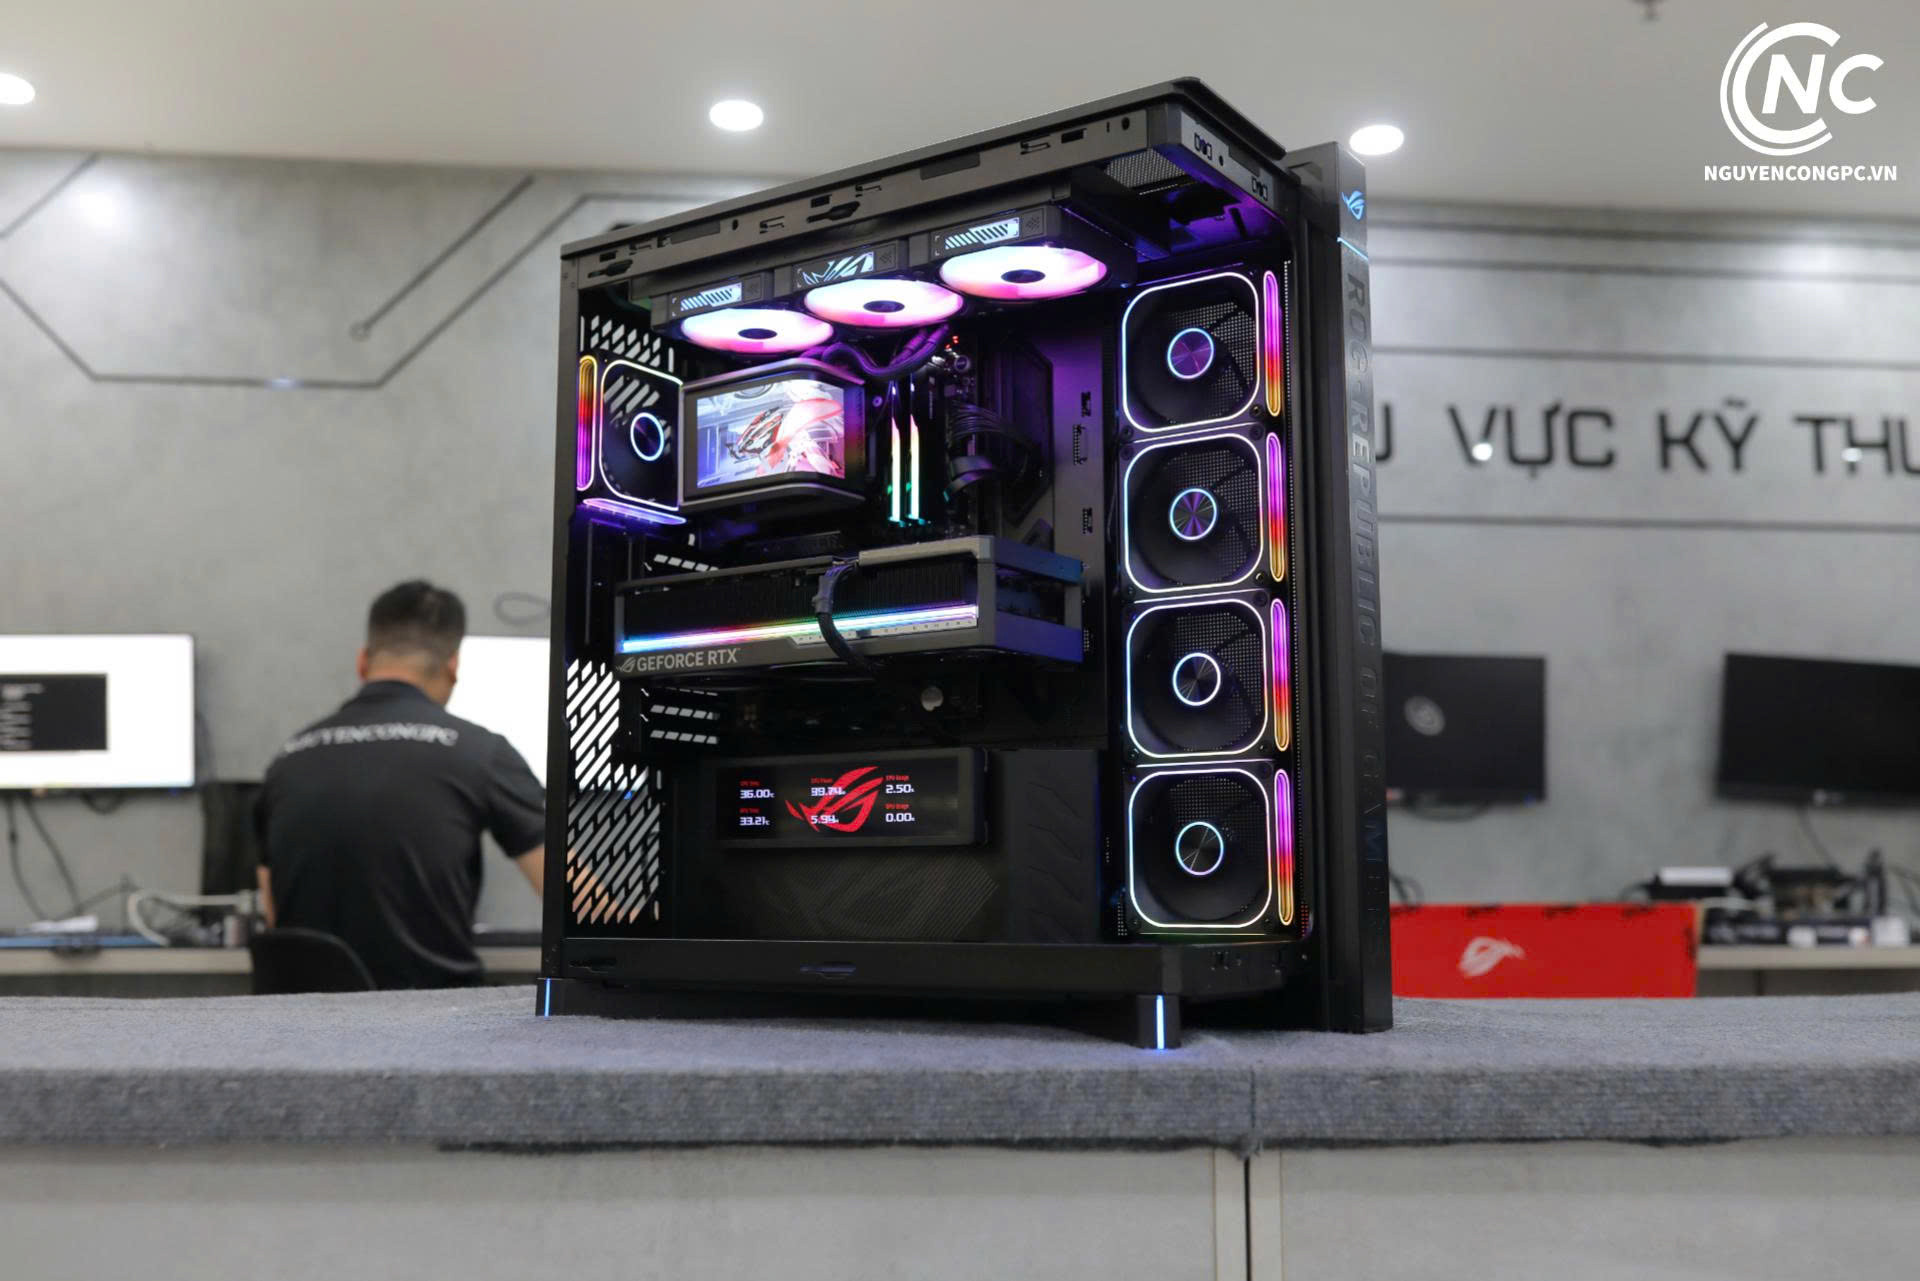
Card RTX 5090 32GB lắp trong bộ PC AI tại Nguyễn Công PC
KV cache: phần dễ bị bỏ quên khi tính VRAM
KV cache tăng tuyến tính theo số token trong ngữ cảnh. Với Llama 3.1 8B (32 lớp, 8 đầu KV, mỗi đầu 128 chiều) và cấu hình Llama 3.1 70B (80 lớp, 8 đầu KV, mỗi đầu 128 chiều), nếu lưu ở định dạng 16 bit thì mỗi token tốn khoảng 128KiB ở model 8B và 320KiB ở model 70B. Bảng dưới là phép tính từ các thông số đó.
Độ dài ngữ cảnh
KV cache model 8B (GiB)
KV cache model 70B (GiB)
8k token
1,0
2,5
32k token
4,0
10,0
128k token
16,0
40,0
Nguồn: cấu hình Llama 3.1 8B và 70B do Meta công bố, lấy từ bản sao trên Hugging Face, tính bằng 2 x số lớp x số đầu KV x số chiều mỗi đầu x 2 byte x số token. Model khác có số liệu khác.
Hãy thử ghép với bảng trên. Model 70B ở Q4 chiếm khoảng 39,9GiB, thêm 2,5GiB KV cache ở ngữ cảnh 8k là khoảng 42,4GiB, nằm trong card 48GB. Nhưng nếu mở ngữ cảnh 32k, tổng lên khoảng 49,9GiB và vượt 48GB. Với model 8B, trọng số 4,6GiB nghe rất nhẹ, song ở ngữ cảnh 128k cần thêm 16GiB KV cache, tổng khoảng 20,6GiB. Ngoài ra, tài liệu Ollama cho biết Ollama tự đặt ngữ cảnh mặc định 4k khi VRAM dưới 24GiB, 32k khi từ 24 đến 48GiB và 256k khi từ 48GiB trở lên, đồng thời khuyến nghị tối thiểu 64k token cho các tác vụ agent và công cụ lập trình. Dùng agent nghĩa là bạn cần nhiều VRAM hơn mức chỉ chat.
Model MoE như gpt-oss cần bao nhiêu bộ nhớ?
MoE là kiến trúc chỉ kích hoạt một phần tham số cho mỗi token. Theo OpenAI, gpt-oss-20b có 21 tỷ tham số tổng và khoảng 3,6 tỷ tham số hoạt động, cần 16GB bộ nhớ; gpt-oss-120b có 117 tỷ tham số tổng và khoảng 5,1 tỷ hoạt động, chạy được trong 80GB bộ nhớ GPU. Trọng số của cả hai được phát hành ở dạng MXFP4. Bài của NVIDIA về chạy gpt-oss trên card GeForce RTX nêu Ollama cần GPU từ 24GB VRAM, còn các ứng dụng như llama.cpp và Microsoft Foundry Local cần từ 16GB VRAM.
Hệ quả thực tế là bộ nhớ vẫn phải chứa toàn bộ tham số tổng, nhưng lượng tính toán mỗi token chỉ theo phần hoạt động. Vì vậy, theo nhận định của Nguyễn Công PC, model MoE lớn hợp với máy có nhiều bộ nhớ như nền tảng 128GB hợp nhất hoặc card 48GB trở lên hơn là card 16GB.
RAM hệ thống: khi nào cần và cần bao nhiêu?
Nếu model nằm trọn trong VRAM, RAM hệ thống chỉ cần đủ cho hệ điều hành và công cụ đi kèm. RAM trở nên quan trọng khi model lớn hơn VRAM và phần mềm đẩy một phần sang RAM. Corsair đưa ra các con số đáng chú ý:
VRAM của RTX 4090 và RTX 5090 vượt 1TB/s, trong khi RAM DDR5 hai kênh khoảng 90GB/s.
Model nằm trọn trong VRAM chạy trên 40 token mỗi giây, còn chạy từ RAM trên CPU nhanh chỉ khoảng 8 đến 15 token mỗi giây.
Nâng RAM từ DDR5-4800 lên DDR5-6000 tăng tốc độ sinh token trên CPU khoảng 20 đến 23% với Mistral 7B và Llama 3.1 8B; cắm hai thanh chạy hai kênh nhanh hơn một thanh khoảng 30 đến 50%.
Nếu chạy hoàn toàn bằng RAM, 32GB đủ cho model 32B và 64GB trở lên mới hợp với 70B ở Q4 hoặc Q5.
Theo nhận định của Nguyễn Công PC, bạn nên chọn RAM tối thiểu bằng kích thước file model cộng thêm 8 đến 16GB cho hệ điều hành, và nên dùng hai thanh DDR5 tốc độ cao ở hai kênh. Nếu muốn đào sâu chuyện này, bài 128GB RAM có đủ cho AI không phân tích riêng cách cắm 2 thanh hay 4 thanh và những thứ khác ăn RAM, còn danh mục RAM DDR5 có sẵn các bộ nhớ để bạn chọn.
CPU cho PC chạy AI local: nên ưu tiên gì?
Theo Corsair, token đầu tiên bị giới hạn bởi sức tính toán, còn mỗi token sau đó bị giới hạn bởi tốc độ bộ nhớ vì bộ xử lý phải đọc lại toàn bộ trọng số cho mỗi token. Nói cách khác, CPU nhanh hơn không làm model chạy nhanh hơn nhiều khi model đã nằm trong VRAM. Theo nhận định của Nguyễn Công PC, bạn nên chọn CPU theo các việc đi kèm như xử lý dữ liệu, chạy cơ sở dữ liệu hay nhiều ứng dụng cùng lúc, và ưu tiên nền tảng hỗ trợ RAM DDR5 hai kênh cùng đủ khe PCIe cho số card cần lắp. Dòng Threadripper chỉ đáng cân nhắc khi bạn cần nhiều card hoặc nhiều kênh RAM hơn nền tảng phổ thông.
10 cấu hình PC chạy AI local theo 5 tầng ngân sách
Mười bộ dưới đây chia theo 5 tầng giá, mỗi tầng 2 bộ, đều là sản phẩm có trên web, thông số lấy từ bảng thông số của từng sản phẩm. Mức tiền là giá niêm yết của từng bộ và thay đổi theo thời điểm, nên bạn hãy xem giá hiện tại trên thẻ sản phẩm. Bài chưa đưa số token mỗi giây cho từng bộ vì chưa có phép đo thử chính thức; khả năng chạy model ở đây được tính từ hai bảng VRAM và KV cache phía trên. Số liệu của hãng và các tài liệu nguồn được tra cứu tại thời điểm viết bài và có thể thay đổi, nên bạn hãy đối chiếu lại trên trang nguồn trước khi mua.
Tầm 50 đến 100 triệu: 16GB VRAM cho model nhỏ và vừa
Bộ 1: Ryzen 7 9800X3D, RTX 5070 Ti 16GB, RAM 32GB
Cấu hình chi tiết:
CPU: AMD Ryzen 7 9800X3D Tray (8 nhân Zen 5, boost 5,2GHz, cache 96MB)
VGA: Gigabyte GeForce RTX 5070 Ti GAMING OC 16G
RAM: Corsair Vengeance RGB 32GB DDR5 6000MHz
SSD: Kioxia Exceria Basic 1TB NVMe Gen 4x4
Mainboard: ASUS TUF GAMING X870-PLUS WIFI
Nguồn: FSP Hydro PTM X PRO 1200W 80 Plus Platinum (ATX 3.0, PCIe 5.0)
Case: GAMDIAS ATLAS P2 CG
Tản nhiệt: AIO Gamdias CHIONE P5-360 PRO Black
Bộ PC Ryzen 7 9800X3D, RTX 5070 Ti 16GB tại Nguyễn Công PC
Đây là mức vào cửa của tầng này. Card RTX 5070 Ti thuộc dòng card RTX 5000 có 16GB VRAM, đủ cho model 8B ở Q4 kể cả ngữ cảnh 32k (khoảng 8,6GiB) và model 14B ở Q4 (khoảng 8GiB trọng số), đồng thời vừa chạm mức 16GB mà OpenAI nêu cho gpt-oss-20b. Model 32B Q4 khoảng 18,2GiB nên không nằm gọn trong card này. CPU 8 nhân là đủ khi model nằm trọn trong VRAM, vì theo Corsair tốc độ từng token phụ thuộc chủ yếu vào bộ nhớ.
[Products:25609]
Bộ 2: Core Ultra 7 265K, RTX 5070 Ti 16GB, RAM 64GB
Bộ PC Core Ultra 7 265K, RTX 5070 Ti 16GB tại Nguyễn Công PC
Card vẫn là RTX 5070 Ti 16GB nên giới hạn cỡ model giống bộ 1, khác ở RAM 64GB DDR5 6000 và CPU 20 nhân. RAM nhiều hơn cho phép chạy model 32B Q4 (khoảng 18,2GiB) theo kiểu lai: phần vừa VRAM nằm trên card, phần còn lại nằm trong RAM nên tốc độ giảm. Nếu bạn chủ yếu chạy model 8B đến 14B thì RAM 32GB ở bộ 1 là đủ; nếu hay thử model lớn hơn thì bộ này hợp lý hơn.
[Products:28080]
Tầm 100 đến 200 triệu: card mạnh hơn hoặc bộ nhớ hợp nhất 128GB
Bộ 1: Ryzen 9 9950X3D, RTX 5080 16GB, RAM 64GB
Cấu hình chi tiết:
CPU: AMD Ryzen 9 9950X3D Tray (16 nhân 32 luồng, Base 4,3GHz, Turbo 5,7GHz, cache 144MB gồm L2 16MB và L3 128MB)
VGA: ASUS ROG Astral RTX 5080 16GB GDDR7 OC Edition
Nguồn: FSP Hydro PTM X PRO 1200W 80 Plus Platinum (ATX 3.0, PCIe 5.0)
Case: ASUS ROG CRONOX GR801 CURVE TG SCREEN Black (không kèm quạt)
Tản nhiệt: ASUS ROG Ryuo IV SLC 360 ARGB
Bộ PC Agent Computer Ryzen 9 9950X3D, RTX 5080 tại Nguyễn Công PC
Card RTX 5080 cũng có 16GB VRAM nên cỡ model nạp được giống hai bộ ở tầng trước; khác biệt nằm ở sức tính toán của card, và bài này chưa có số đo để so sánh. Điểm cộng của bộ là CPU 16 nhân, RAM 64GB và tản nước 360, hợp khi bạn vừa chạy AI vừa làm việc khác trên cùng một máy. Bộ này nằm trong danh mục Agent Computer của shop.
[Products:30534]
Bộ 2: MSI EdgeXpert, chip NVIDIA GB10, 128GB bộ nhớ hợp nhất
Cấu hình chi tiết:
Model: MSI EdgeXpert-55SVN (MS-C931), AI Mini PC
CPU và GPU: NVIDIA Grace Blackwell GB10, ARM 20 nhân
Hiệu năng AI: 1 PetaFLOP (FP4 Sparse), khoảng 1000 AI TOPS
Bộ nhớ: 128GB LPDDR5x hợp nhất, hàn chết, không nâng cấp
Ổ cứng: 4TB M.2 NVMe tự mã hóa
Mạng: 10GbE, NVIDIA ConnectX-7 200Gbps, Wi-Fi 7
Hệ điều hành: DGX OS; kích thước 151 x 151 x 52mm, nặng 1,2kg; bảo hành 36 tháng
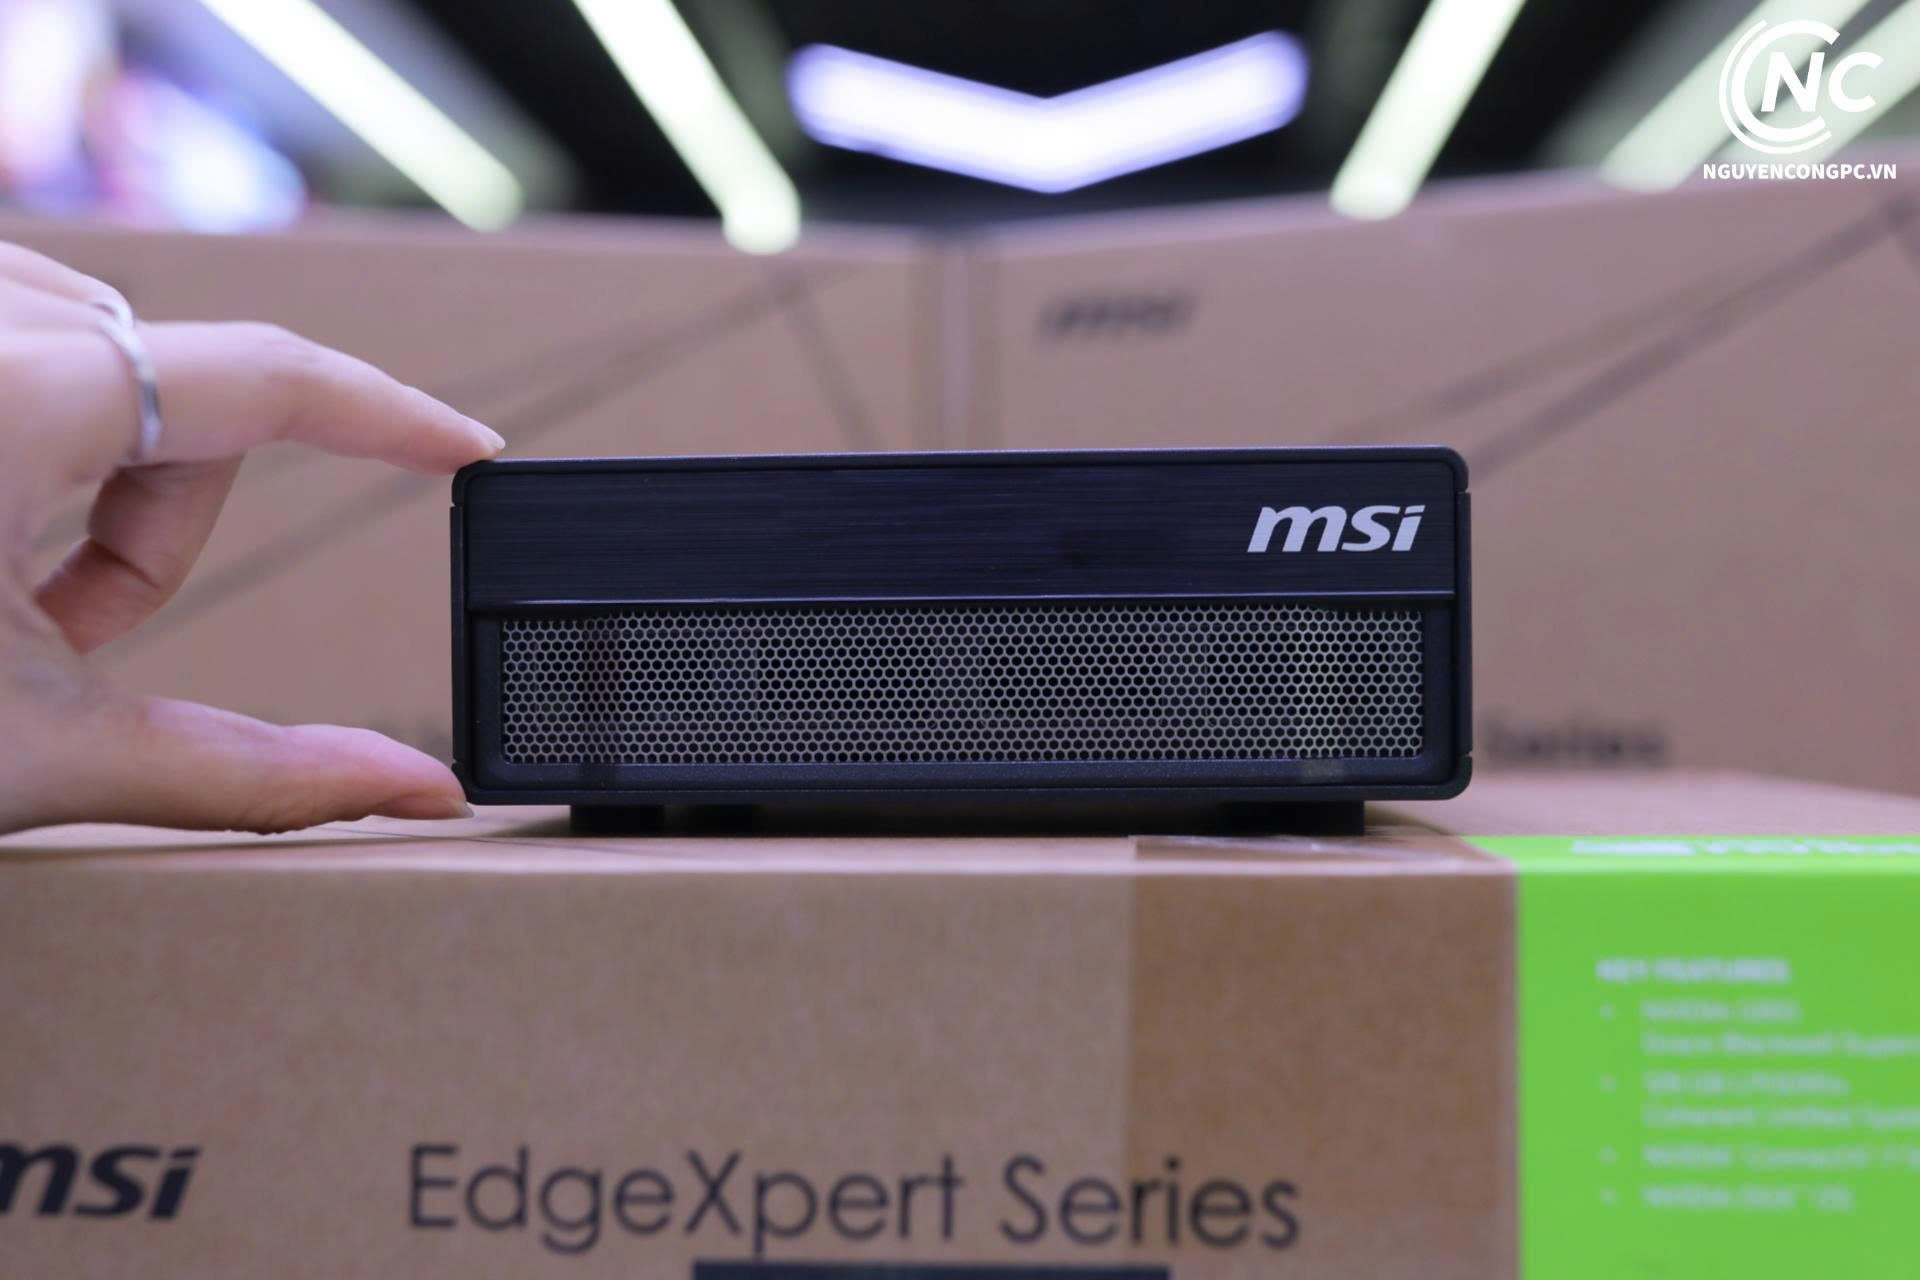
Mini PC AI MSI EdgeXpert 55SVN
Máy dùng chip NVIDIA GB10 với 128GB bộ nhớ hợp nhất dùng chung cho CPU và GPU, nên dung lượng chạy model lớn hơn mọi card đơn ở tầng này. NVIDIA nêu nền tảng 128GB ứng với khoảng 120 đến 200 tỷ tham số; theo hai bảng trên, model 70B Q4 và gpt-oss-120b đều nằm trong tầm này. Điểm cần cân nhắc là chip ARM nên bạn phải kiểm tra phần mềm mình dùng trước khi mua, và RAM hàn chết nên không nâng cấp được về sau.
[Products:29769]
Tầm 200 đến 300 triệu: nền tảng workstation hoặc card 48GB
Bộ 1: Threadripper 9960X, RTX 5080 16GB, RAM 64GB ECC
Cấu hình chi tiết:
CPU: AMD Ryzen Threadripper 9960X (24 nhân 48 luồng, 4,2GHz tới 5,4GHz, cache 152MB, PCIe 5.0)
Bộ PC AI Threadripper 9960X, RTX 5080 16GB tại Nguyễn Công PC
Phần lớn ngân sách của bộ này nằm ở nền tảng Threadripper 9960X với 8 khe RAM DDR5 và RAM ECC, chứ không nằm ở VRAM vì card RTX 5080 vẫn chỉ có 16GB. RAM hiện là 64GB và còn khe trống để nâng dần, nên bộ hợp máy AI nội bộ cần mở rộng RAM về sau, theo nhận định của Nguyễn Công PC. Nếu mục tiêu chính là nạp model lớn vào VRAM thì bạn nên xem bộ RTX PRO 5000 48GB ngay bên dưới.
[Products:16309]
Bộ 2: Ryzen 9 9950X, RTX PRO 5000 Blackwell 48GB, RAM 64GB
Cấu hình chi tiết:
CPU: AMD Ryzen 9 9950X Tray (16 nhân 32 luồng, Base 4,3GHz, boost 5,7GHz, cache L3 64MB)
Nguồn: ASUS TUF Gaming 1200G EVO 1200W (80 Plus Gold, ATX 3.1, PCIe 5.1)
Case: ASUS A31 TG Black
Tản nhiệt: ASUS PRIME LC 360 ARGB
Bộ PC Agent Computer Ryzen 9 9950X, RTX PRO 5000 Blackwell 48GB (ảnh dựng của sản phẩm)
Card RTX PRO 5000 Blackwell có 48GB VRAM nên model 70B Q4 (khoảng 39,9GiB) nạp trọn cùng khoảng 2,5GiB KV cache ở ngữ cảnh 8k, tổng khoảng 42,4GiB. Ở ngữ cảnh 32k tổng lên khoảng 49,9GiB và không còn vừa, đúng như ví dụ ở phần KV cache. Đây là cách chạy 70B bằng một card duy nhất, không phải chia model qua nhiều card, và RAM 64GB đủ cho phần việc còn lại.
[Products:30363]
Tầm 300 đến 500 triệu: hai card RTX 5090 cho 64GB VRAM và model 70B
RAM: 2 bộ Corsair Vengeance RGB Black 96GB (2 x 48GB) DDR5 6000MHz (tổng 192GB)
SSD: Samsung 9100 Pro 2TB PCIe Gen5 NVMe
Mainboard: Gigabyte Z790 AORUS MASTER DDR5
Nguồn: Cooler Master M2000 Platinum 2000W 80 Plus Platinum
Case: ASUS ProArt PA602 Black (E-ATX)
Tản nhiệt: Deepcool Mystique 360 AIO
Bộ PC AI Core i9-14900K với hai card RTX 5090 tại Nguyễn Công PC
Hai card RTX 5090 cho tổng 64GB VRAM, đủ nạp model 70B Q4 (khoảng 39,9GiB) cùng khoảng 10GiB KV cache ở ngữ cảnh 32k. RAM 192GB nhiều hơn mức 128GB của bộ bên dưới nên phần model tràn ra RAM có chỗ rộng hơn, còn CPU Core i9-14900K có 24 nhân. Việc một model dùng chung VRAM của hai card phụ thuộc phần mềm bạn chọn, nên bạn cần kiểm tra trước khi mua, và nguồn 2000W cùng case E-ATX cho thấy đây là cấu hình lớn.
RAM: 2 bộ Kingston Fury Beast Black RGB 64GB (2 x 32GB) DDR5 6000MHz (tổng 128GB)
SSD: Samsung 990 PRO 2TB
Mainboard: Asus ROG Crosshair X870E Glacial
Nguồn: Super Flower Leadex Platinum 2000W 80 Plus Platinum
Case: Asus ROG Hyperion GR701 White
Tản nhiệt: Asus ROG Ryuo IV SLC 360 ARGB
Bộ PC AI Ryzen 9 9950X với hai card RTX 5090 32GB
Hai card RTX 5090 cho tổng 64GB VRAM, đủ nạp model 70B Q4 (khoảng 39,9GiB) cùng khoảng 10GiB KV cache ở ngữ cảnh 32k. Việc một model dùng chung VRAM của hai card hay không phụ thuộc phần mềm bạn chọn, nên bạn nên kiểm tra trước khi mua. RAM 128GB DDR5 và nguồn Platinum 2000W phục vụ cấu hình hai card; đây là cấu hình lớn nên bạn cần tính cả chỗ đặt và chi phí điện.
[Products:29264]
Tầm 1 tỷ: máy trạm nhiều RAM và hai card 32GB
Bộ 1: GIGABYTE AI TOP 500, Threadripper PRO 7965WX, RTX 5090, RAM 768GB
Cấu hình chi tiết:
Dòng: AI TOP 500 Workstation
CPU: AMD Ryzen Threadripper PRO 7965WX; chipset TRX50 AI TOP
Bộ này cho phép nạp model rất lớn vào RAM với 768GB DDR5 ECC, trong khi card RTX 5090 chỉ có 32GB VRAM. Phần model nằm trong VRAM chạy nhanh, phần nằm trong RAM chạy chậm hơn, và tốc độ phụ thuộc băng thông RAM nên bạn nên thử trên đúng model cần dùng; bài này chưa có số đo cho bộ này. Theo nhận định của Nguyễn Công PC, bộ hợp doanh nghiệp cần giữ nhiều model hoặc ngữ cảnh rất lớn cùng lúc hơn là người cần tốc độ cao với model 70B.
[Products:29427]
Bộ 2: Threadripper PRO 9985WX, 2 card RTX 5090, RAM 256GB
Cấu hình chi tiết:
CPU: AMD Ryzen Threadripper PRO 9985WX
VGA: 2 x Asus ROG Astral GeForce RTX 5090 32GB GDDR7 OC
SSD: 2 x Samsung 990 PRO 2TB; HDD: 2 x WD Ultrastar 8TB 3.5 inch SATA
Nguồn: Cooler Master M2000 Platinum 2000W 80 Plus Platinum
Case: Cooler Master HAF 700 EVO
Tản nhiệt: Thermaltake AW420 AIO Liquid Cooler
Bộ PC AI Threadripper PRO 9985WX với hai card RTX 5090 tại Nguyễn Công PC
Hai card RTX 5090 cho tổng 64GB VRAM, nạp được model 70B Q4 (khoảng 39,9GiB) cùng khoảng 10GiB KV cache ở ngữ cảnh 32k, còn RAM 256GB ECC chứa phần vượt khi cần. Việc chia model qua hai card phụ thuộc phần mềm, và nguồn 2000W cùng hai ổ HDD 8TB cho thấy đây là máy trạm để lưu cả dữ liệu lớn. Theo nhận định của Nguyễn Công PC, bộ hợp doanh nghiệp muốn một máy suy luận nội bộ mạnh cho cả nhóm dùng chung.
[Products:28571]
Ba sai lầm thường gặp khi build PC chạy AI local
Chọn card 12GB mạnh hơn thay vì card 16GB. Khi model không vừa VRAM, phần mềm phải đẩy sang RAM và tốc độ giảm mạnh, như ví dụ 8 đến 15 token mỗi giây so với trên 40 mà Corsair nêu. Với AI local, dung lượng VRAM thường quan trọng hơn xung nhịp của card.
Không tính KV cache. Model 70B Q4 nằm vừa card 48GB ở ngữ cảnh 8k, nhưng chạm khoảng 49,9GiB ở ngữ cảnh 32k và không còn vừa. Nếu bạn dùng agent hoặc công cụ lập trình, hãy tính theo ngữ cảnh 32k đến 64k thay vì mức mặc định.
Mua RAM thật nhiều để thay cho VRAM. RAM giúp model lớn chạy được nhưng chậm, vì băng thông RAM DDR5 hai kênh khoảng 90GB/s so với trên 1TB/s của VRAM card cao cấp. RAM nhiều hợp với việc chứa dữ liệu và chạy nhiều tác vụ hơn là tăng tốc model.
Câu hỏi thường gặp
Chạy model 8B cần bao nhiêu VRAM?
Trọng số model 8B ở Q4_K_M khoảng 4,58GiB theo tài liệu llama.cpp. Cộng KV cache khoảng 1GiB ở ngữ cảnh 8k và 4GiB ở ngữ cảnh 32k theo cấu hình Llama 3.1 8B, nên card 8GB đủ cho ngữ cảnh ngắn, còn 12GB thoải mái hơn nếu bạn mở ngữ cảnh dài.
16GB VRAM chạy được model cỡ nào?
Card 16GB chạy thoải mái model 8B và 14B ở Q4. OpenAI nêu gpt-oss-20b cần 16GB nên đây là mức sát, không dư. Model 32B Q4 khoảng 18,2GiB nên không nằm gọn trong 16GB và phải đẩy một phần sang RAM, khiến tốc độ giảm.
Chạy model 70B cần cấu hình gì?
Trọng số 70B ở Q4 khoảng 39,9GiB, cộng KV cache khoảng 2,5GiB ở ngữ cảnh 8k là khoảng 42,4GiB, nên cần tối thiểu 48GB VRAM. Các hướng thực tế gồm một card 48GB, hai card 32GB (tổng 64GB), hoặc nền tảng 128GB bộ nhớ hợp nhất. Nếu thiếu VRAM, bạn có thể đẩy phần còn lại sang RAM nhưng tốc độ giảm rõ.
RAM hệ thống cần bao nhiêu để chạy AI local?
Khi model nằm trọn trong VRAM, RAM chỉ cần đủ cho hệ điều hành và công cụ, theo nhận định của Nguyễn Công PC thường là 32GB. Nếu muốn đẩy model lớn sang RAM, Corsair nêu 64GB trở lên mới hợp với model 70B ở Q4 hoặc Q5 khi chạy bằng RAM, và nên dùng hai thanh DDR5 để chạy hai kênh.
Chạy AI local có cần CPU mạnh không?
Không nhiều. Corsair nêu token đầu tiên bị giới hạn bởi sức tính toán còn mỗi token sau bị giới hạn bởi tốc độ bộ nhớ, nên khi model đã nằm trong VRAM thì CPU nhanh hơn ít cải thiện tốc độ. Bạn nên chọn CPU theo các việc đi kèm và nền tảng RAM, PCIe hơn là chạy theo số nhân.
Kết luận
Để build PC chạy AI local, bạn hãy bắt đầu từ cỡ model cần chạy, tính trọng số theo mức lượng tử hóa, cộng KV cache theo ngữ cảnh mong muốn rồi mới chọn VRAM. Với 16GB bạn chạy tốt model 8B và 14B, với 32GB hợp model 32B, còn model 70B trở lên cần từ 48GB VRAM hoặc nền tảng bộ nhớ hợp nhất 128GB. RAM và CPU là phần hỗ trợ, không thay được VRAM. Nếu muốn xem thêm các bộ có sẵn, bạn có thể tham khảo danh mục PC AI trí tuệ nhân tạo tại Nguyễn Công PC.
MIL-STD-810H là bộ phương pháp thử nghiệm môi trường, không phải chứng nhận của quân đội. Bài viết giải thích các hạng mục thử trên laptop, hiểu lầm thường gặp và cách đọc thông số khi chọn mua.
Card đồ họa chạy DeepSeek cần bao nhiêu VRAM? Dung lượng từng bản DeepSeek-R1, card RTX 5060 đến RTX 5090 phù hợp bản nào, DeepSeek V4 có chạy được không và gợi ý bộ PC.
Đánh giá Acer Nitro ProPanel ANV16-I12-53VH (Nitro V 16): Core 5 205H, RTX 3050 4GB, màn 16 inch 16:10 165Hz, điểm benchmark, so sánh với ANV15-52-50VA và ai nên chọn.
So sánh Core Ultra 7 265K, 265KF, 270K Plus và Core Ultra 9 285K theo thông số Intel, cách ghép card đồ họa, RAM và 8 bộ PC gaming Core Ultra có cấu hình chi tiết.
Mini PC AI GB10 dùng cho chạy mô hình lớn tại chỗ, tinh chỉnh mô hình, dựng ứng dụng AI và xử lý dữ liệu nội bộ. Bài nêu việc máy làm tốt và việc máy không hợp.
So sánh ba mini PC AI dùng chip GB10: MSI EdgeXpert MS-C931, Gigabyte AI TOP ATOM ATAGB10-9000 và ASUS Ascent GX10 theo SSD, cổng kết nối, cân nặng và nhu cầu sử dụng.
DGX Spark là máy tính AI để bàn của NVIDIA dùng chip GB10 với 128 GB bộ nhớ dùng chung. Bài giải thích chip, thông số, việc máy làm được và ai nên mua.











 PC GAMING
 LAPTOP
 LINH KIỆN MÁY TÍNH
 MÀN HÌNH MÁY TÍNH